Qwen-Image ComfyUI原生工作流示例
Qwen-Image 是一个拥有 20B 参数的 MMDiT(多模态扩散变换器)模型,基于 Apache 2.0 许可证开源。
Qwen-Image 是阿里巴巴通义千问团队发布的首个图像生成基础模型,这是一个拥有 20B 参数的 MMDiT(多模态扩散变换器)模型,基于 Apache 2.0 许可证开源。该模型在复杂文本渲染和精确图像编辑方面取得了显著进展,无论是英语还是中文等多种语言都能实现高保真输出。
模型亮点:
- 卓越的多语言文本渲染:支持英语、中文、韩语、日语等多种语言的高精度文本生成,保持字体细节和布局一致性
- 多样化艺术风格:从照片级真实到印象派绘画,从动漫美学到极简设计,流畅适应各种创意提示
相关链接*:
另外目前 Qwen-Image 有多种 ControlNet 支持
- Qwen-Image-DiffSynth-ControlNets/model_patches: 包括 canny、depth、inpaint 三个模型
- qwen_image_union_diffsynth_lora.safetensors: 图像结构控制lora 支持 canny、depth、pose、lineart、softedge、normal、openpose
- instanX ControlNet: 待更新
ComfyOrg Qwen-Image live stream
Qwen-Image in ComfyUI - Lightning & LoRAs
Qwen-Image ControlNet in ComfyUI - DiffSynth
Qwen-Image 原生工作流示例
Qwen-Image:文生图
使用 Qwen-Image 的 20B MMDiT 模型,以出色的多语言文本渲染和编辑能力生成图像。
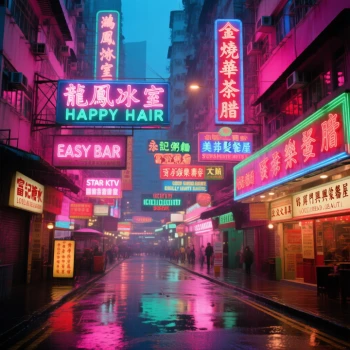
示例输出
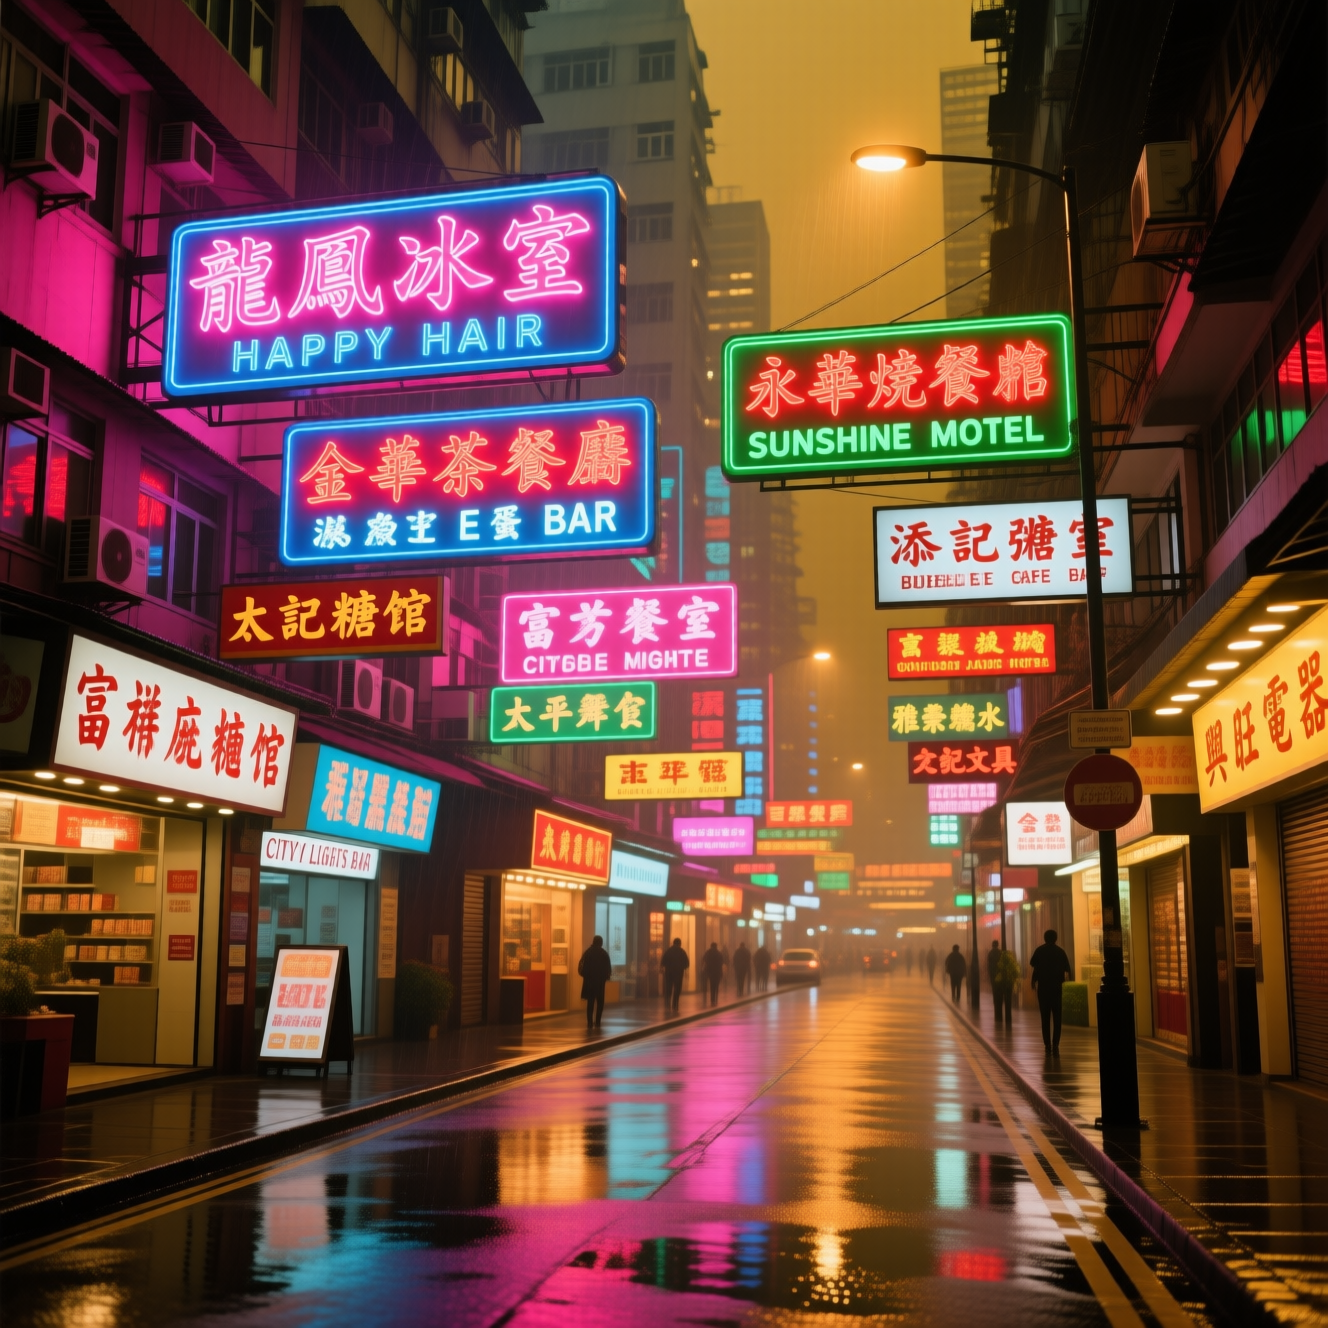
本文档所附工作流中使用了三种不同的模型:
- Qwen-Image 原始模型 fp8_e4m3fn
- 8步加速版:Qwen-Image 原始模型 fp8_e4m3fn 与 lightx2v 8 步 LoRA
- 蒸馏版:Qwen-Image 蒸馏模型 fp8_e4m3fn
显存使用参考 GPU: RTX4090D 24GB
| 使用模型 | 显存占用 | 首次生成 | 第二次生成 |
|---|---|---|---|
| fp8_e4m3fn | 86% | ≈ 94s | ≈ 71s |
| fp8_e4m3fn 与 lightx2v 8 步 LoRA | 86% | ≈ 55s | ≈ 34s |
| 蒸馏版 fp8_e4m3fn | 86% | ≈ 69s | ≈ 36s |
1. 工作流文件
更新 ComfyUI 后,你可以从模板中找到工作流文件,或者将下面的工作流拖入 ComfyUI 中加载。
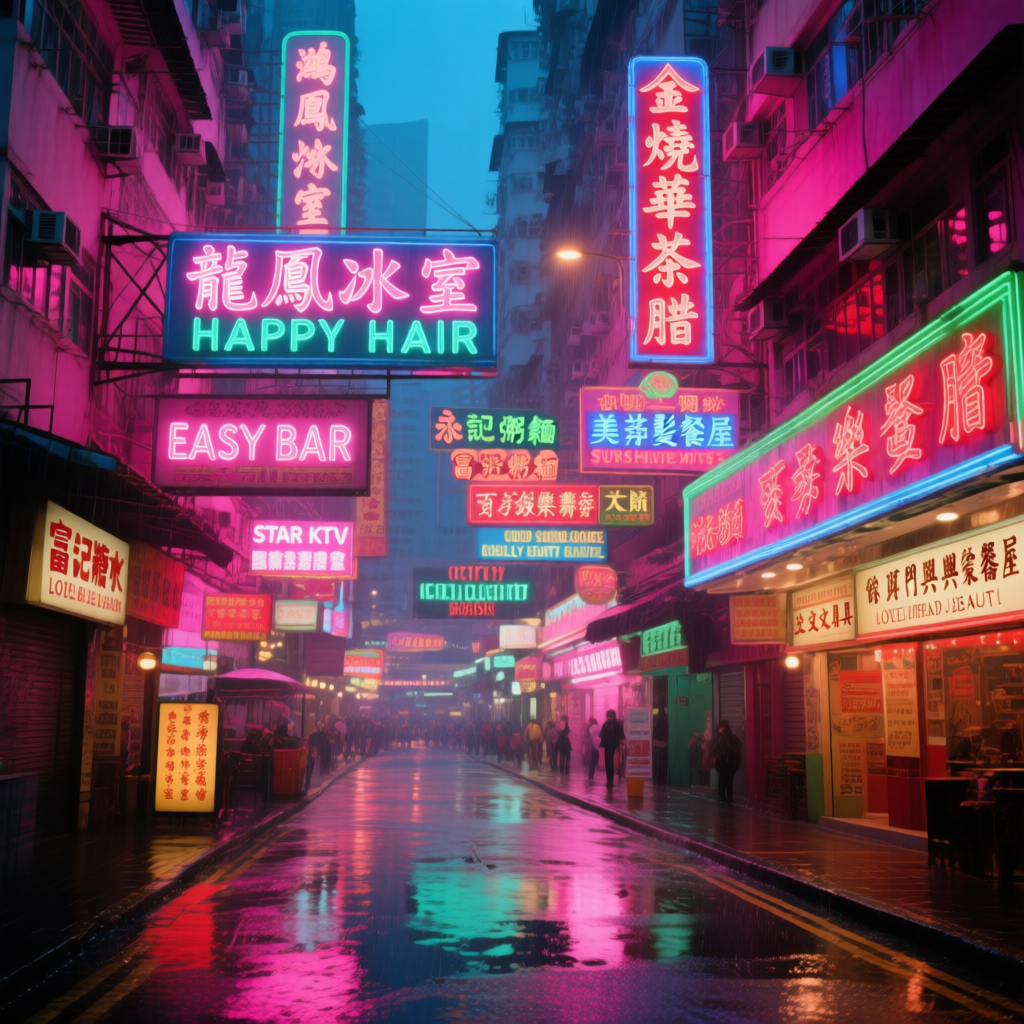
蒸馏版
下载 JSON 工作流
2. 模型下载
ComfyUI 中可用的模型
- Qwen-Image_bf16 (40.9 GB)
- Qwen-Image_fp8 (20.4 GB)
- 蒸馏版(非官方,仅需 15 步)
全部模型均可在 Huggingface 和 ModelScope 找到
Diffusion model
Qwen_image_distill
- 蒸馏版的原始作者建议使用 15 步和 cfg 1.0。
- 根据测试,该蒸馏版在 10 步和 cfg 1.0 下也表现良好。你可以根据想要的图像类型选择 euler 或 res_multistep。
LoRA
文本编码器
VAE
模型保存位置
📂 ComfyUI/
├── 📂 models/
│   ├── 📂 diffusion_models/
│   │   ├── qwen_image_fp8_e4m3fn.safetensors
│   │   └── qwen_image_distill_full_fp8_e4m3fn.safetensors ## 蒸馏版
│   ├── 📂 loras/
│   │   └── Qwen-Image-Lightning-8steps-V1.0.safetensors   ## 8步加速 LoRA 模型
│   ├── 📂 vae/
│   │   └── qwen_image_vae.safetensors
│   └── 📂 text_encoders/
│       └── qwen_2.5_vl_7b_fp8_scaled.safetensors
3. 工作流使用说明
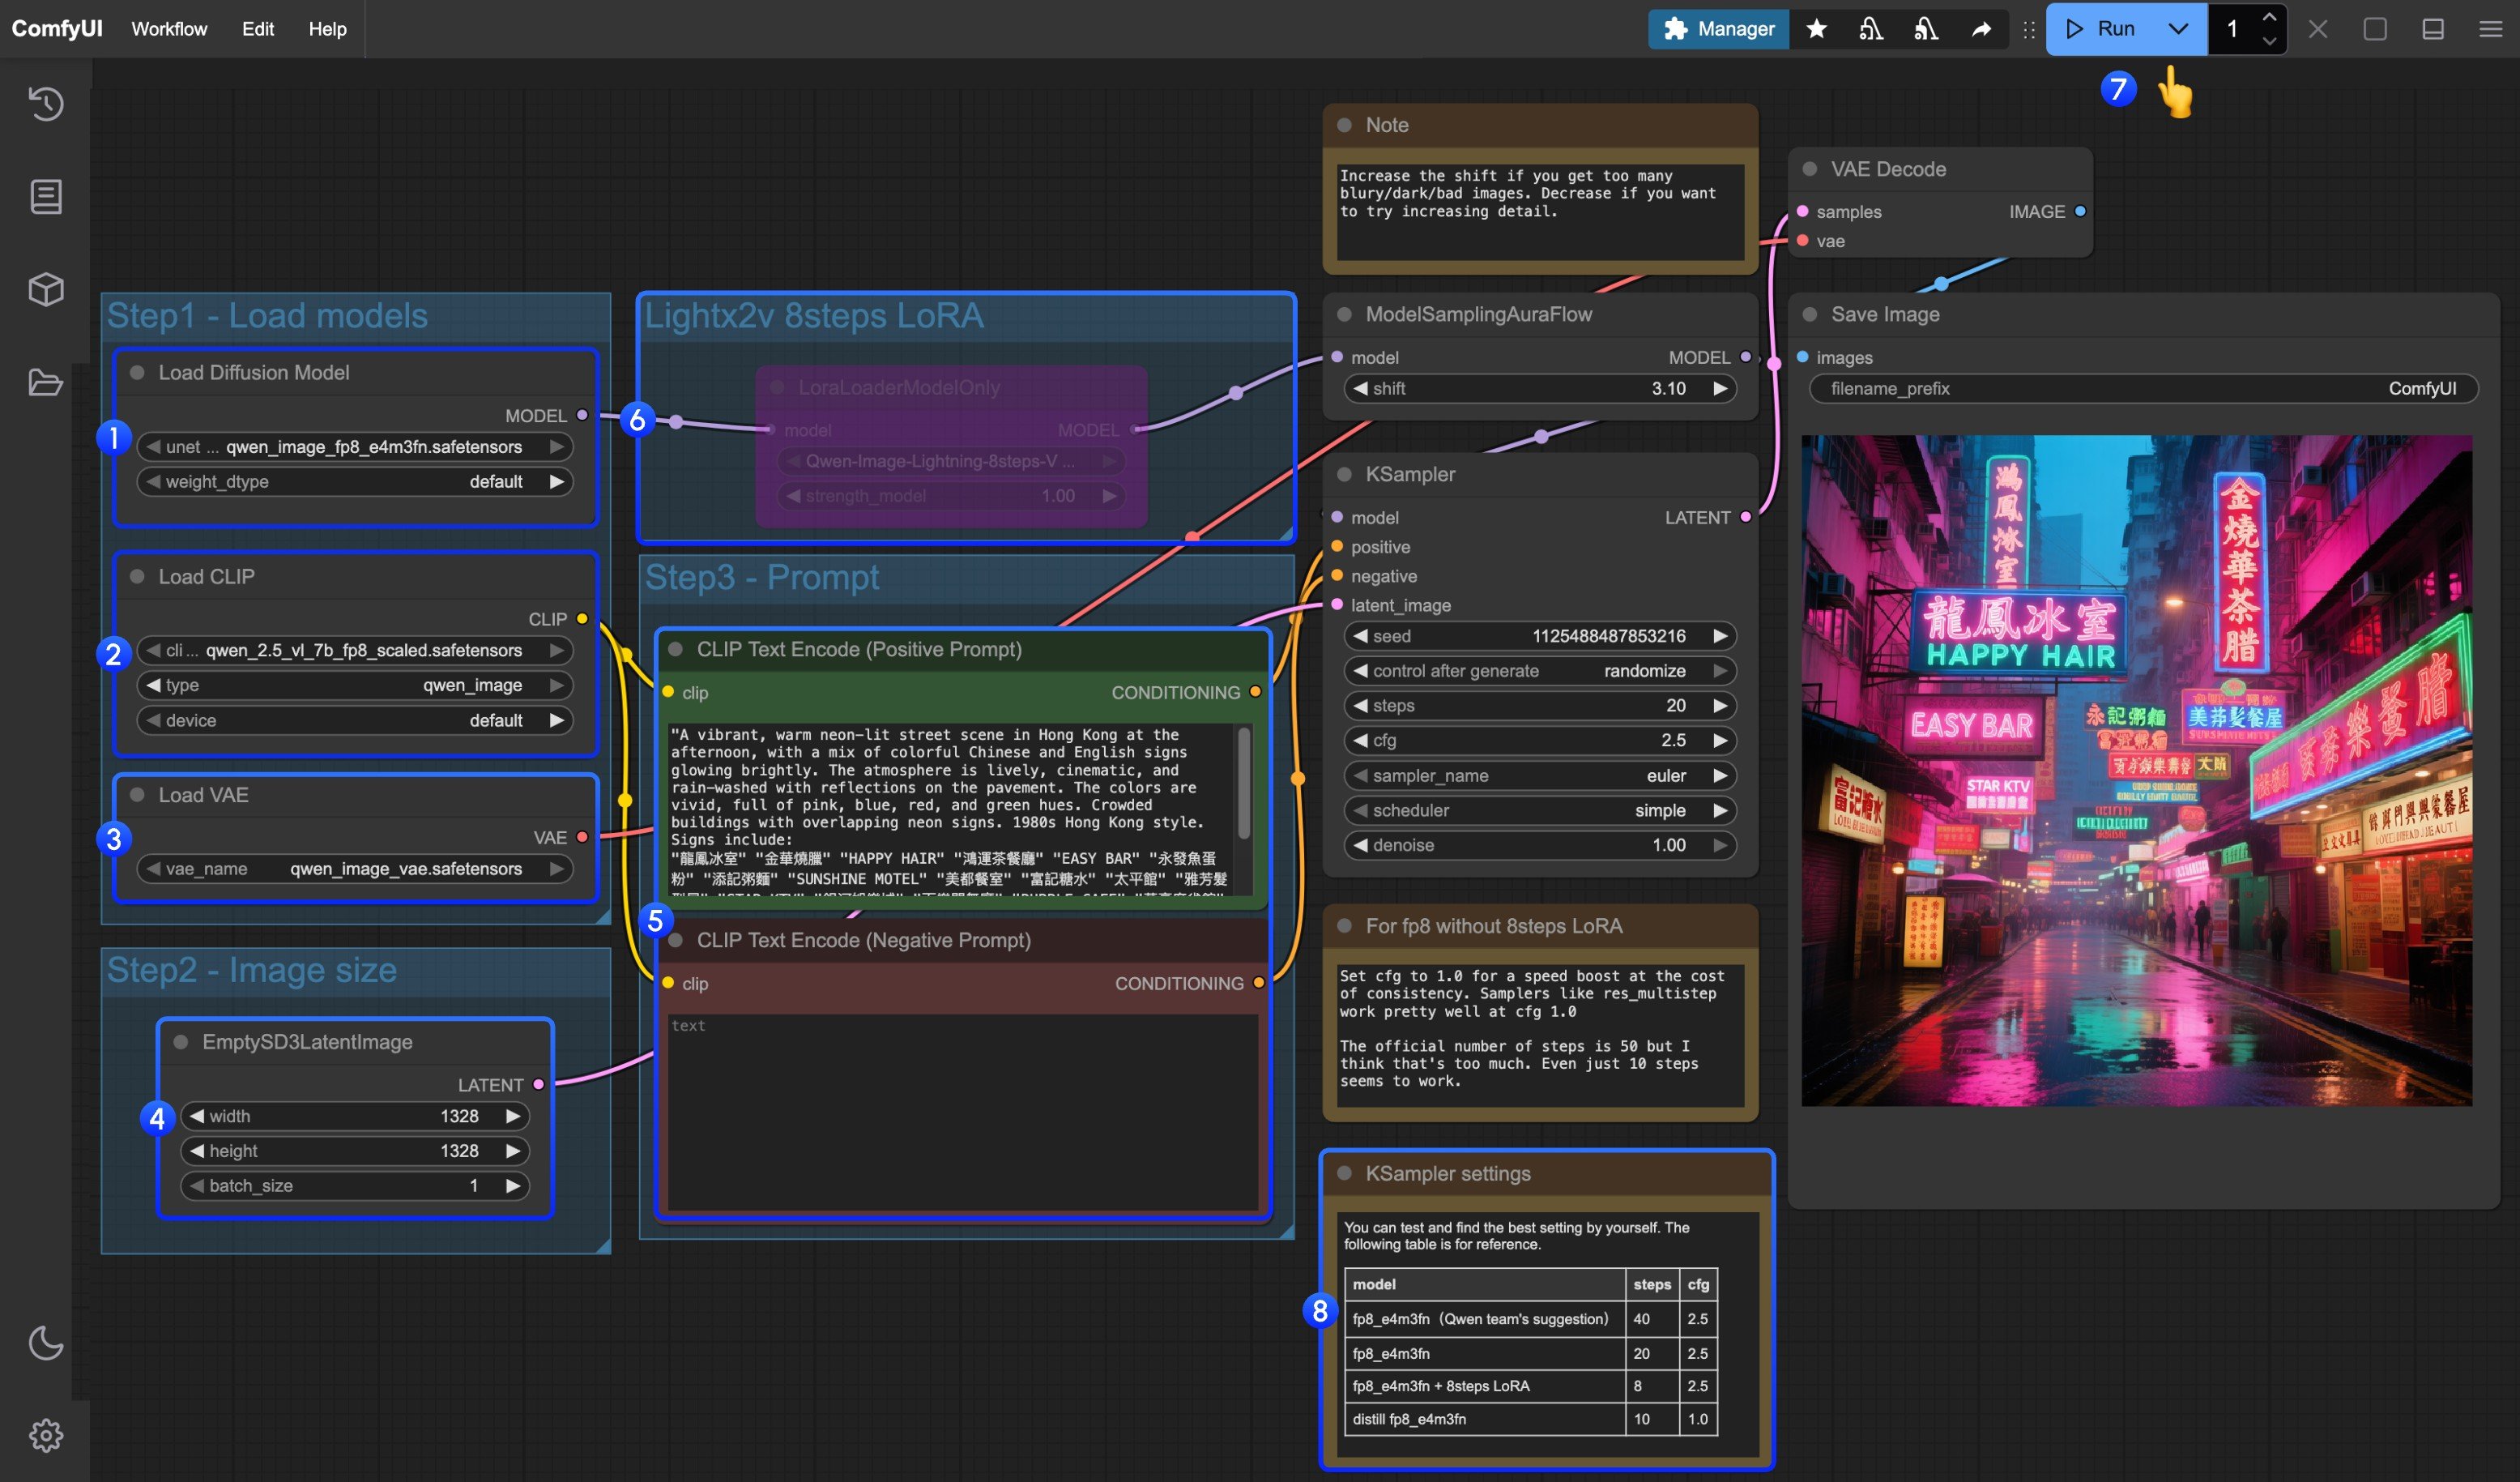
- 确保
Load Diffusion Model节点已加载qwen_image_fp8_e4m3fn.safetensors - 确保
Load CLIP节点已加载qwen_2.5_vl_7b_fp8_scaled.safetensors - 确保
Load VAE节点已加载qwen_image_vae.safetensors - 确保
EmptySD3LatentImage节点已设置正确的图像尺寸 - 在
CLIP Text Encoder节点中设置提示词;目前至少支持英语、中文、韩语、日语、意大利语等。 - 如果要启用 lightx2v 的 8 步加速 LoRA,请选中该节点并使用
Ctrl + B启用,然后按第 8 步中的说明修改 KSampler 设置。 - 点击
Queue按钮,或使用快捷键Ctrl(cmd) + Enter运行工作流。 - 对于不同的模型版本和工作流,请相应调整 KSampler 参数。
蒸馏版模型和 lightx2v 的 8 步加速 LoRA 似乎无法同时使用。你可以尝试不同的组合,以验证它们是否可以一起使用。
Qwen Image InstantX ControlNet 工作流
这是一个 ControlNet 模型,因此你可以像使用普通 ControlNet 一样使用它。
Qwen-Image InstantX Union ControlNet
使用 Qwen-Image InstantX ControlNet 生成图像,支持 Canny、软边缘、深度和姿态。
输入素材
将此文件上传到对应的 LoadImage 节点:
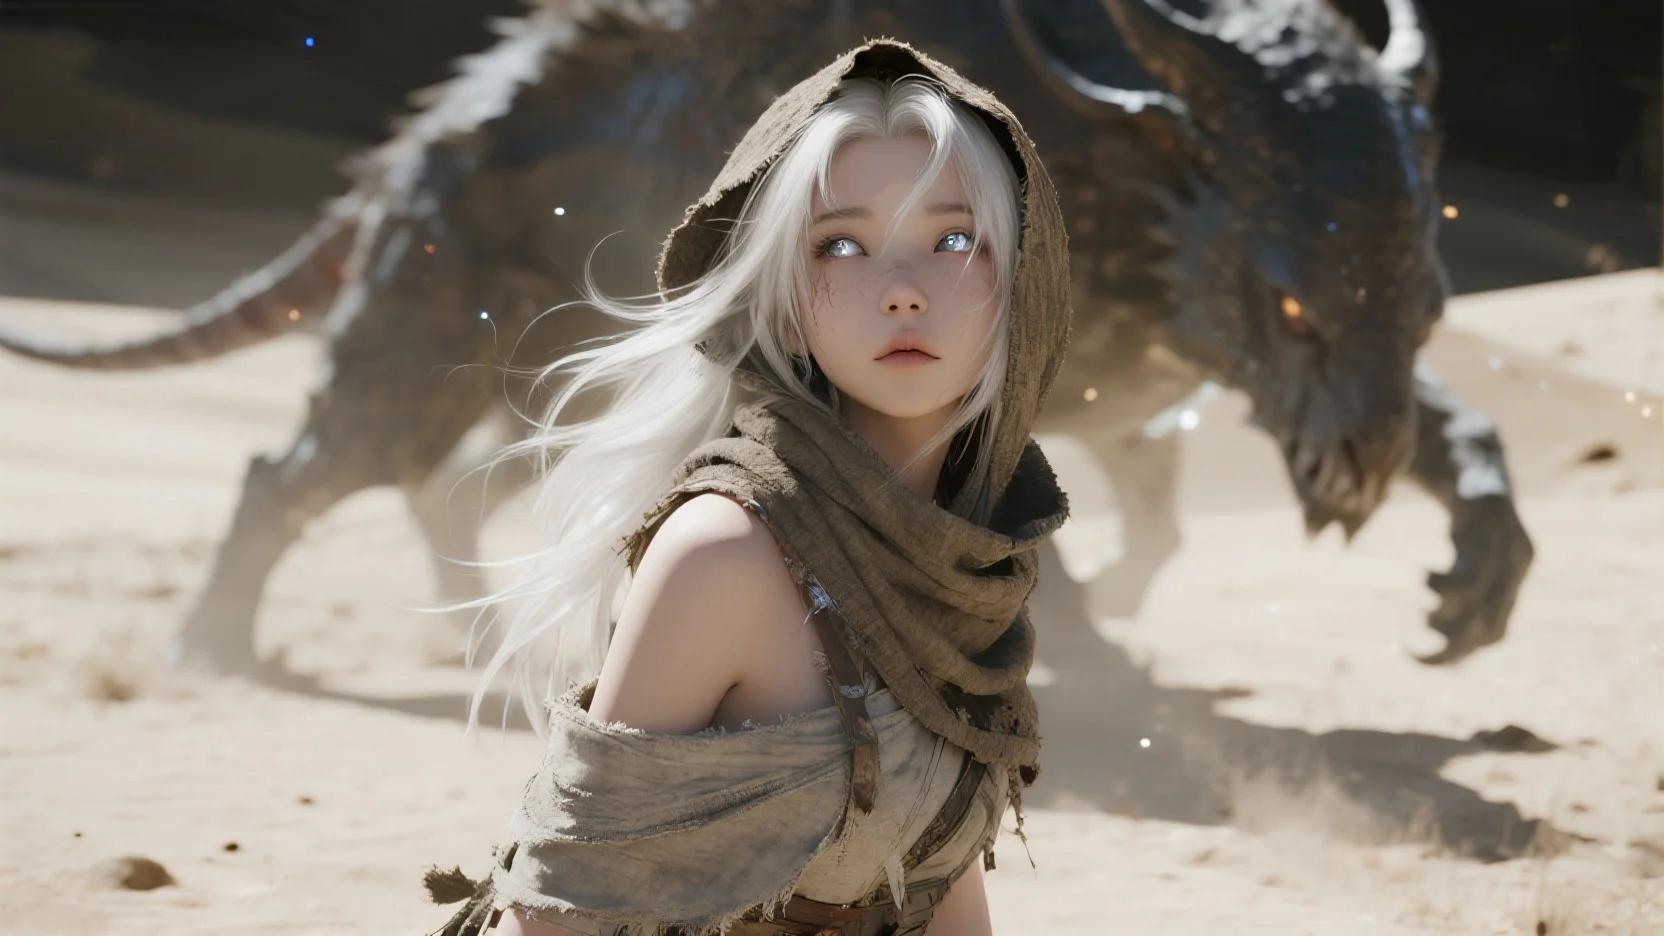
1. 工作流和输入图像
2. 模型链接
- InstantX ControlNet
下载 Qwen-Image-InstantX-ControlNet-Union.safetensors 并将其保存到ComfyUI/models/controlnet/文件夹中
- Lotus Depth模型
我们将使用该模型来生成图像的深度图。需要下载以下两个模型:
Diffusion模型
VAE模型
- vae-ft-mse-840000-ema-pruned.safetensors 或任何SD1.5 VAE
ComfyUI/
├── models/
│   ├── diffusion_models/
│   │   └─── lotus-depth-d-v1-1.safetensors
│   └── vae/
│       └──  lvae-ft-mse-840000-ema-pruned.safetensors
你还可以使用类似 comfyui_controlnet_aux 的自定义节点来生成深度图。
3. 工作流说明
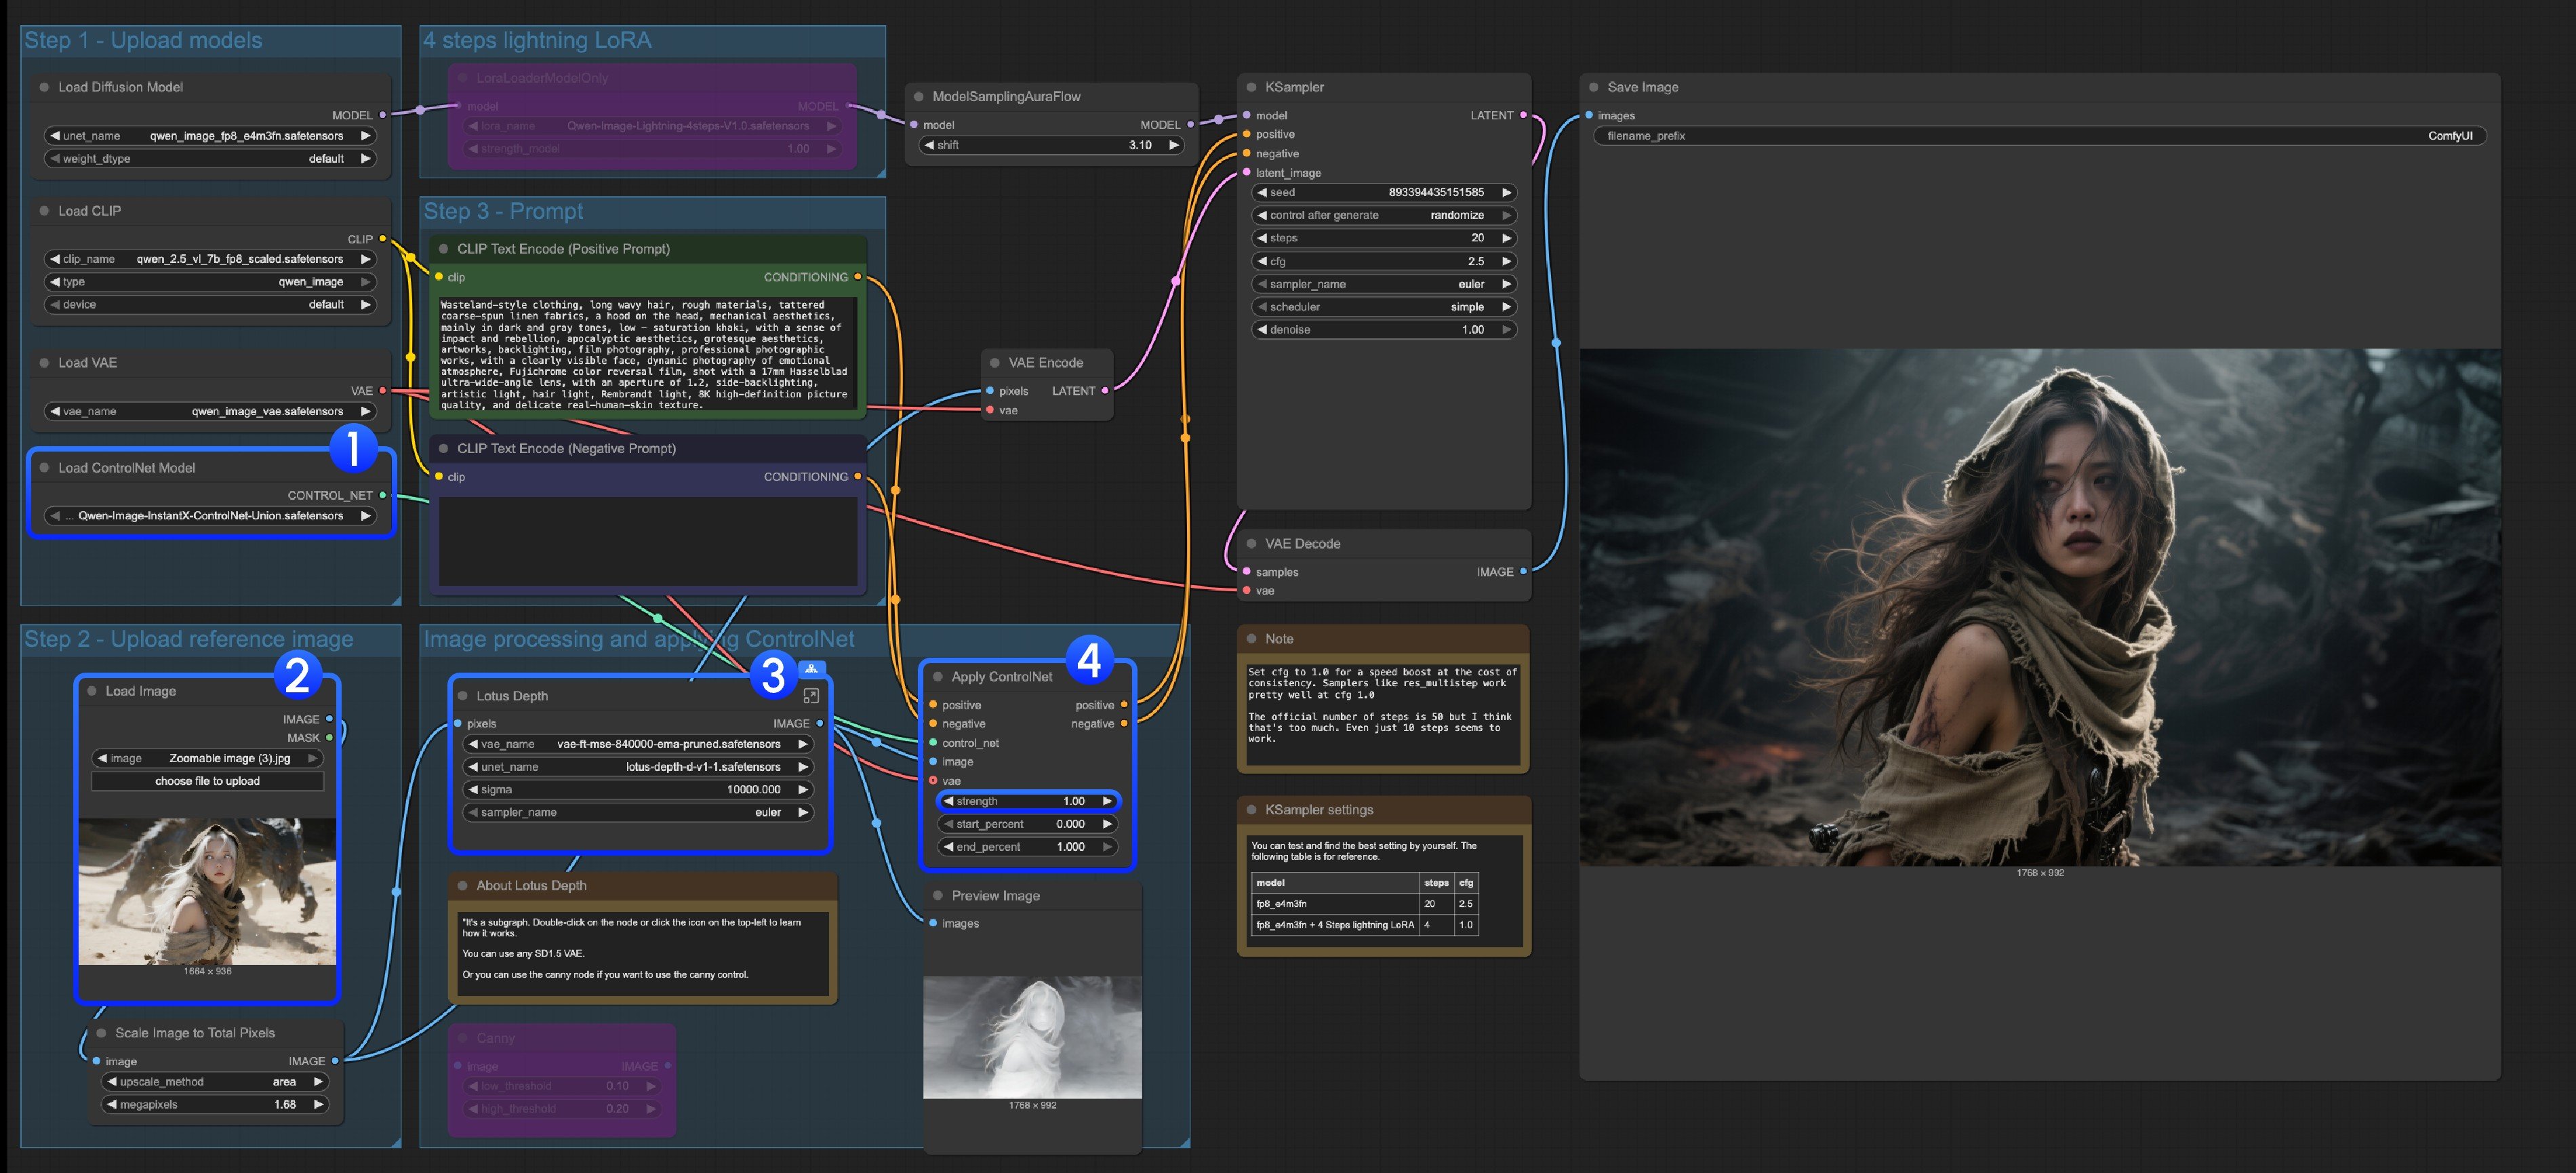
- 确保
加载ControlNet模型节点正确加载了Qwen-Image-InstantX-ControlNet-Union.safetensors模型 - 上传输入图像
- 该子图使用Lotus Depth模型。你可以在模板中找到它,或编辑子图以了解更多信息,确保所有模型都已正确加载
- 点击
运行按钮,或使用快捷键Ctrl(cmd) + Enter来运行工作流
Qwen Image ControlNet DiffSynth-ControlNets Model Patches 工作流
在 Comfy Cloud 上运行
这个模型实际上并不是一个 controlnet,而是一个 Model patch, 支持 canny、depth、inpaint 三种不同的控制模式
原始模型地址:DiffSynth-Studio/Qwen-Image ControlNet Comfy Org rehost 地址: Qwen-Image-DiffSynth-ControlNets/model_patches
1. 工作流及输入图片
下载下面的图片拖入 ComfyUI 中以加载对应的工作流
下载 JSON 格式工作流
下载下面的图片作为输入图片:
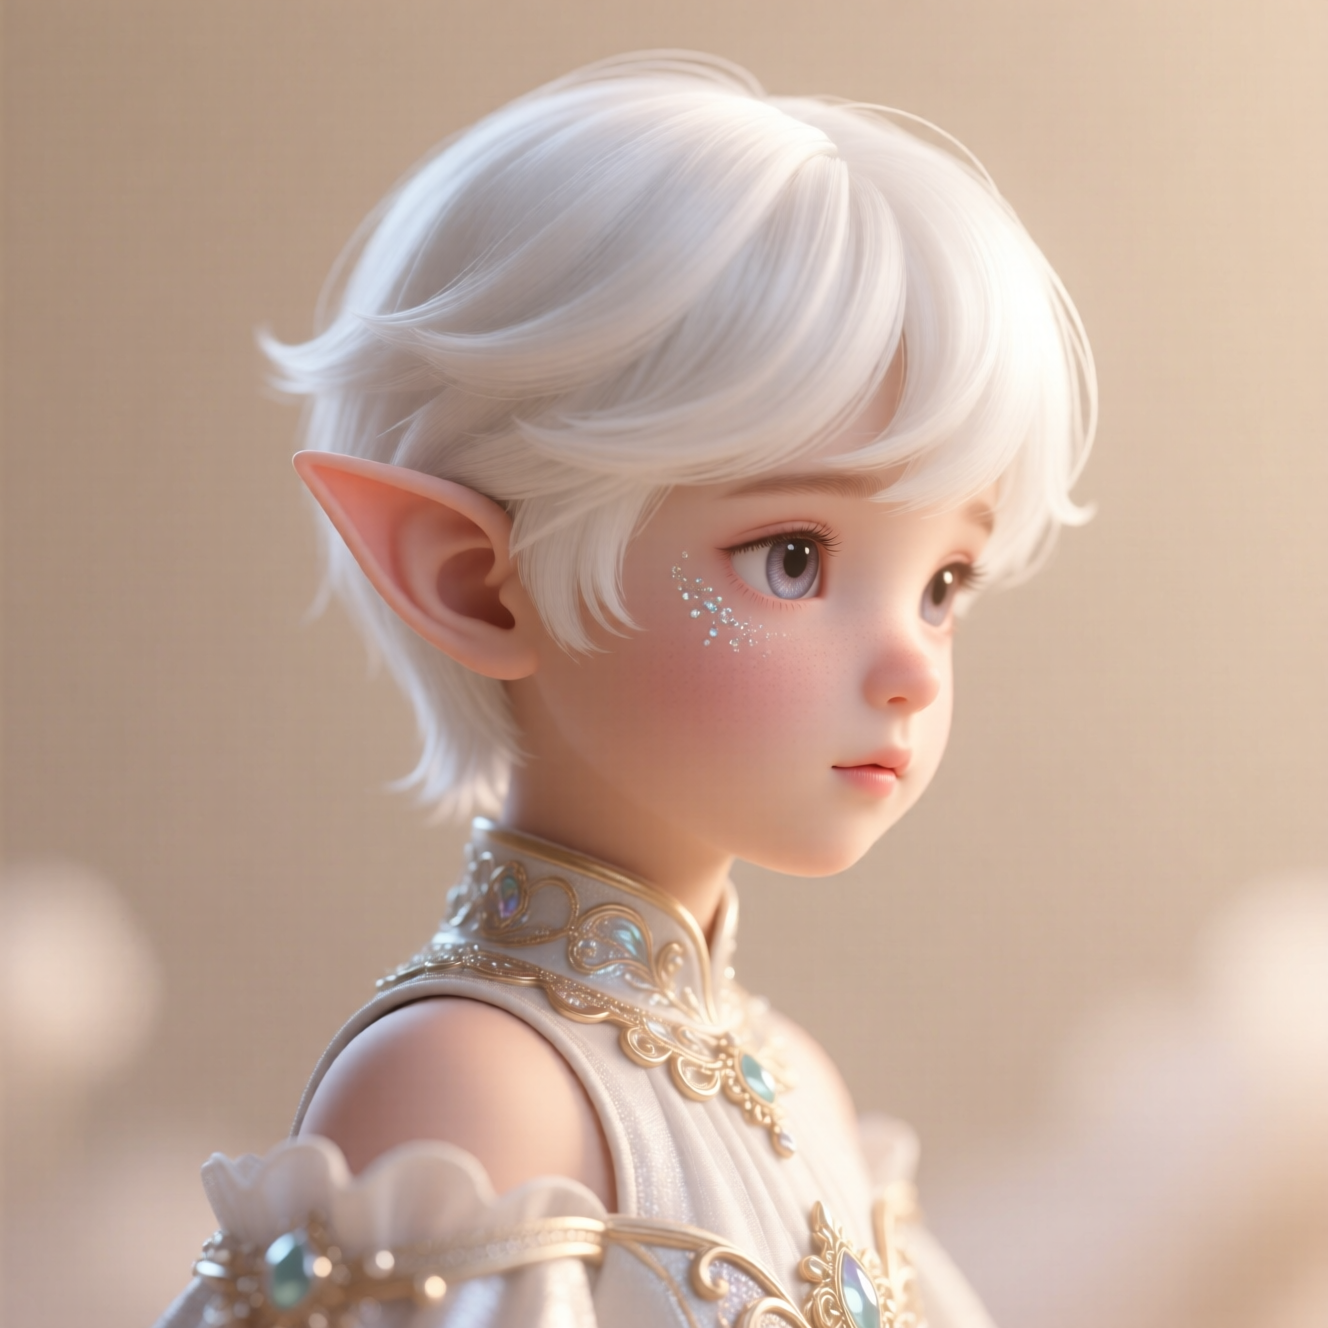
2. 模型链接
其它模型与 Qwen-Image 基础工作流一致,你只需下载下面的模型并保存到 ComfyUI/models/model_patches 文件夹中
- qwen_image_canny_diffsynth_controlnet.safetensors
- qwen_image_depth_diffsynth_controlnet.safetensors
- qwen_image_inpaint_diffsynth_controlnet.safetensors
3. 工作流使用说明
目前 diffsynth 有三个 patch 的模型: Canny、Detph、Inpaint 三个模型
如果你是第一次使用 ControlNet 相关的工作流,你需要了解的是,用于控制的图片需要预处理成受支持的图像才可以被模型使用和识别
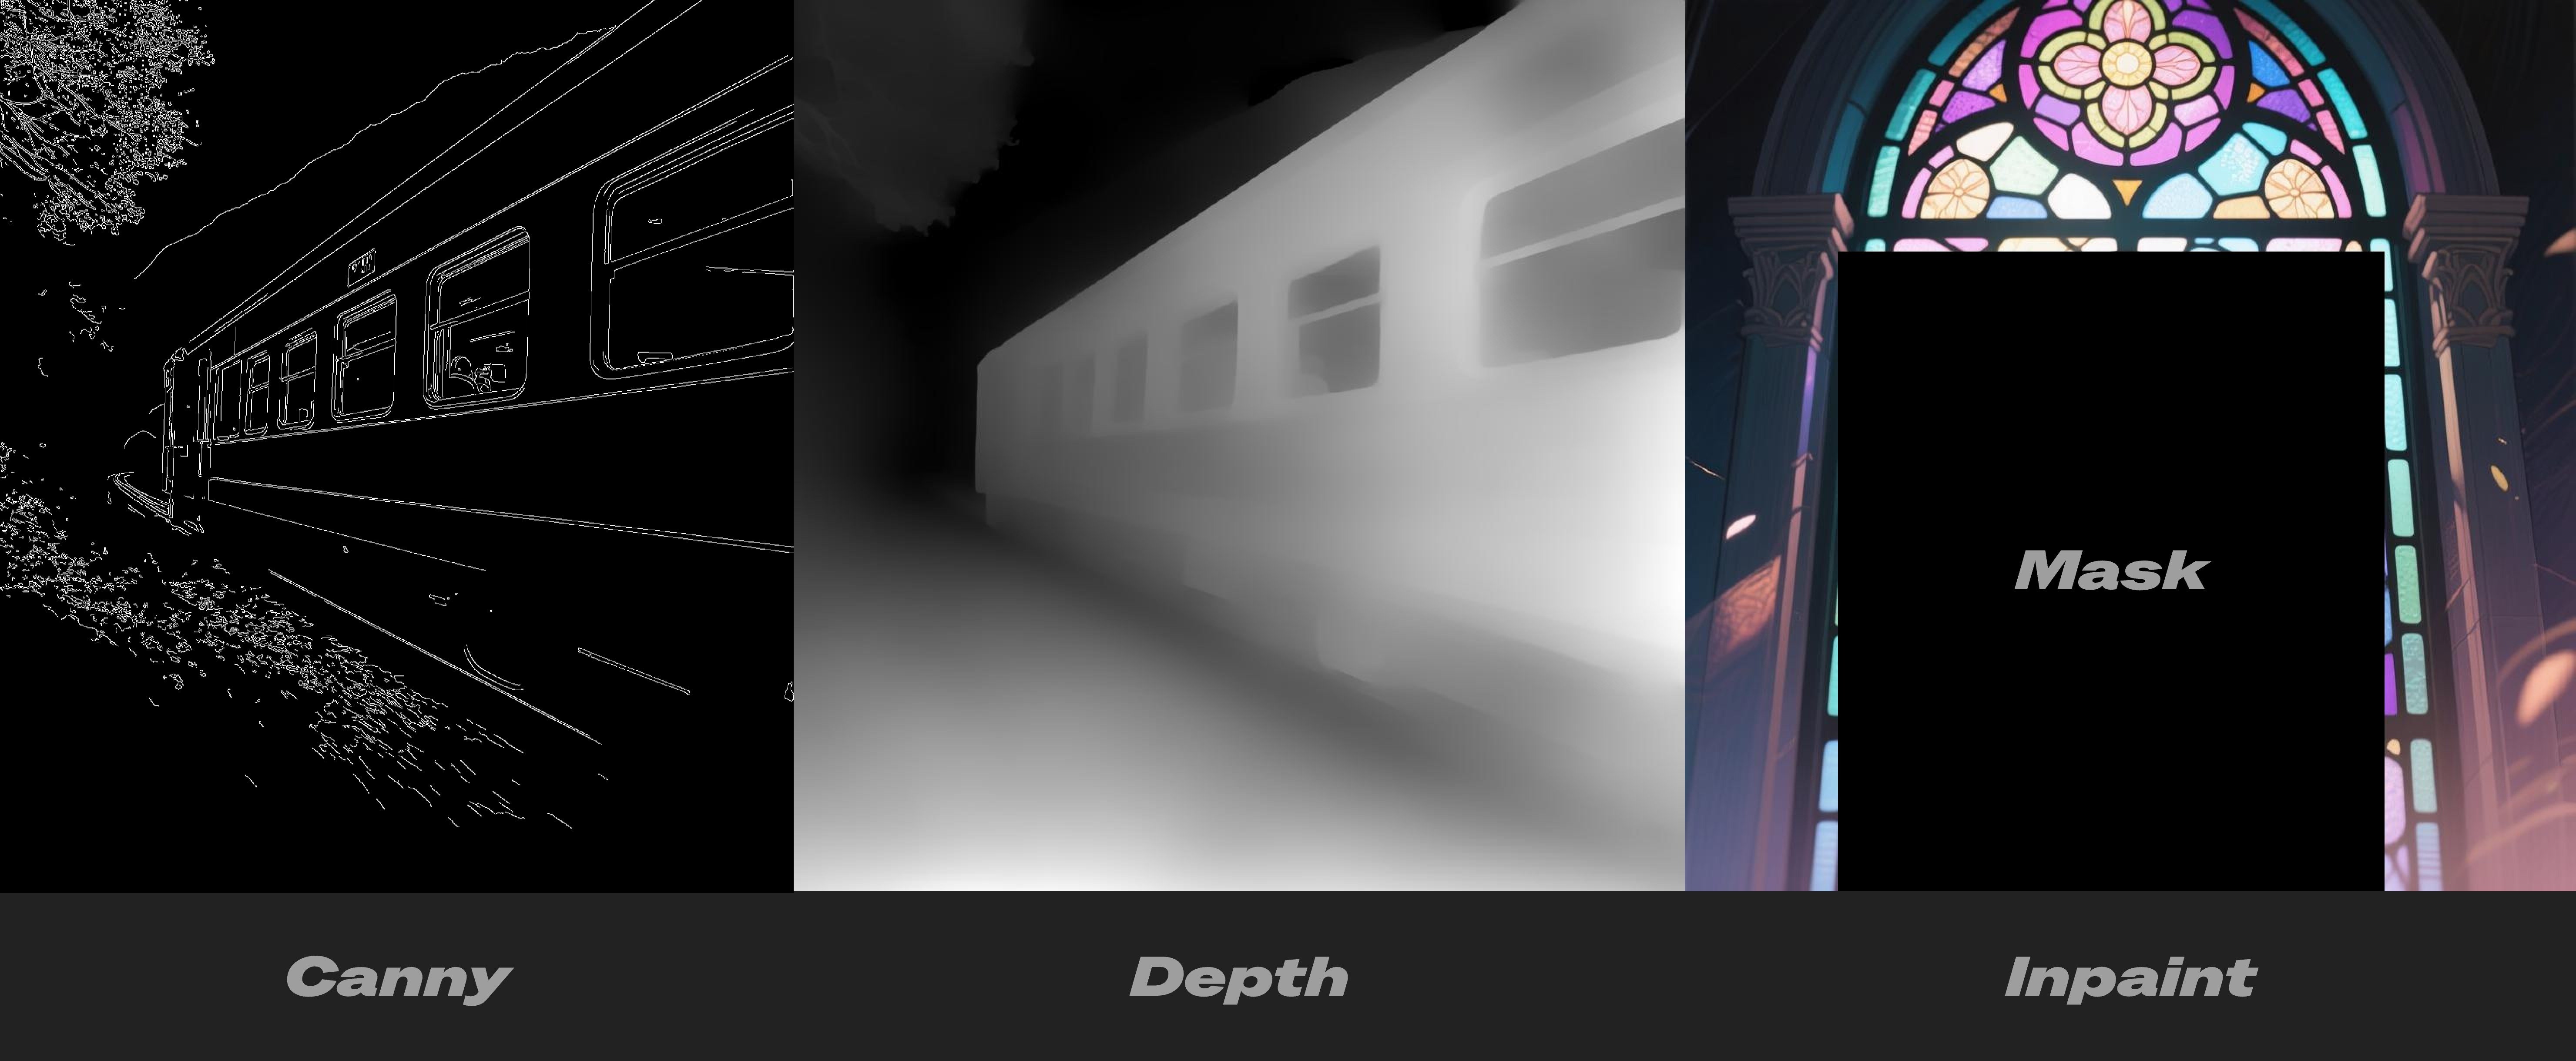
- Canny: 处理后的 canny , 线稿轮廓
- Detph: 预处理后的深度图,体现空间关系
- Inpaint: 需要用 Mask 标记需要重绘的部分
由于这个 patch 模型分为了三个不同的模型,所以你需要在输入时选择正确的预处理类型来保证图像的正确预处理
Canny 模型 ControlNet 使用说明
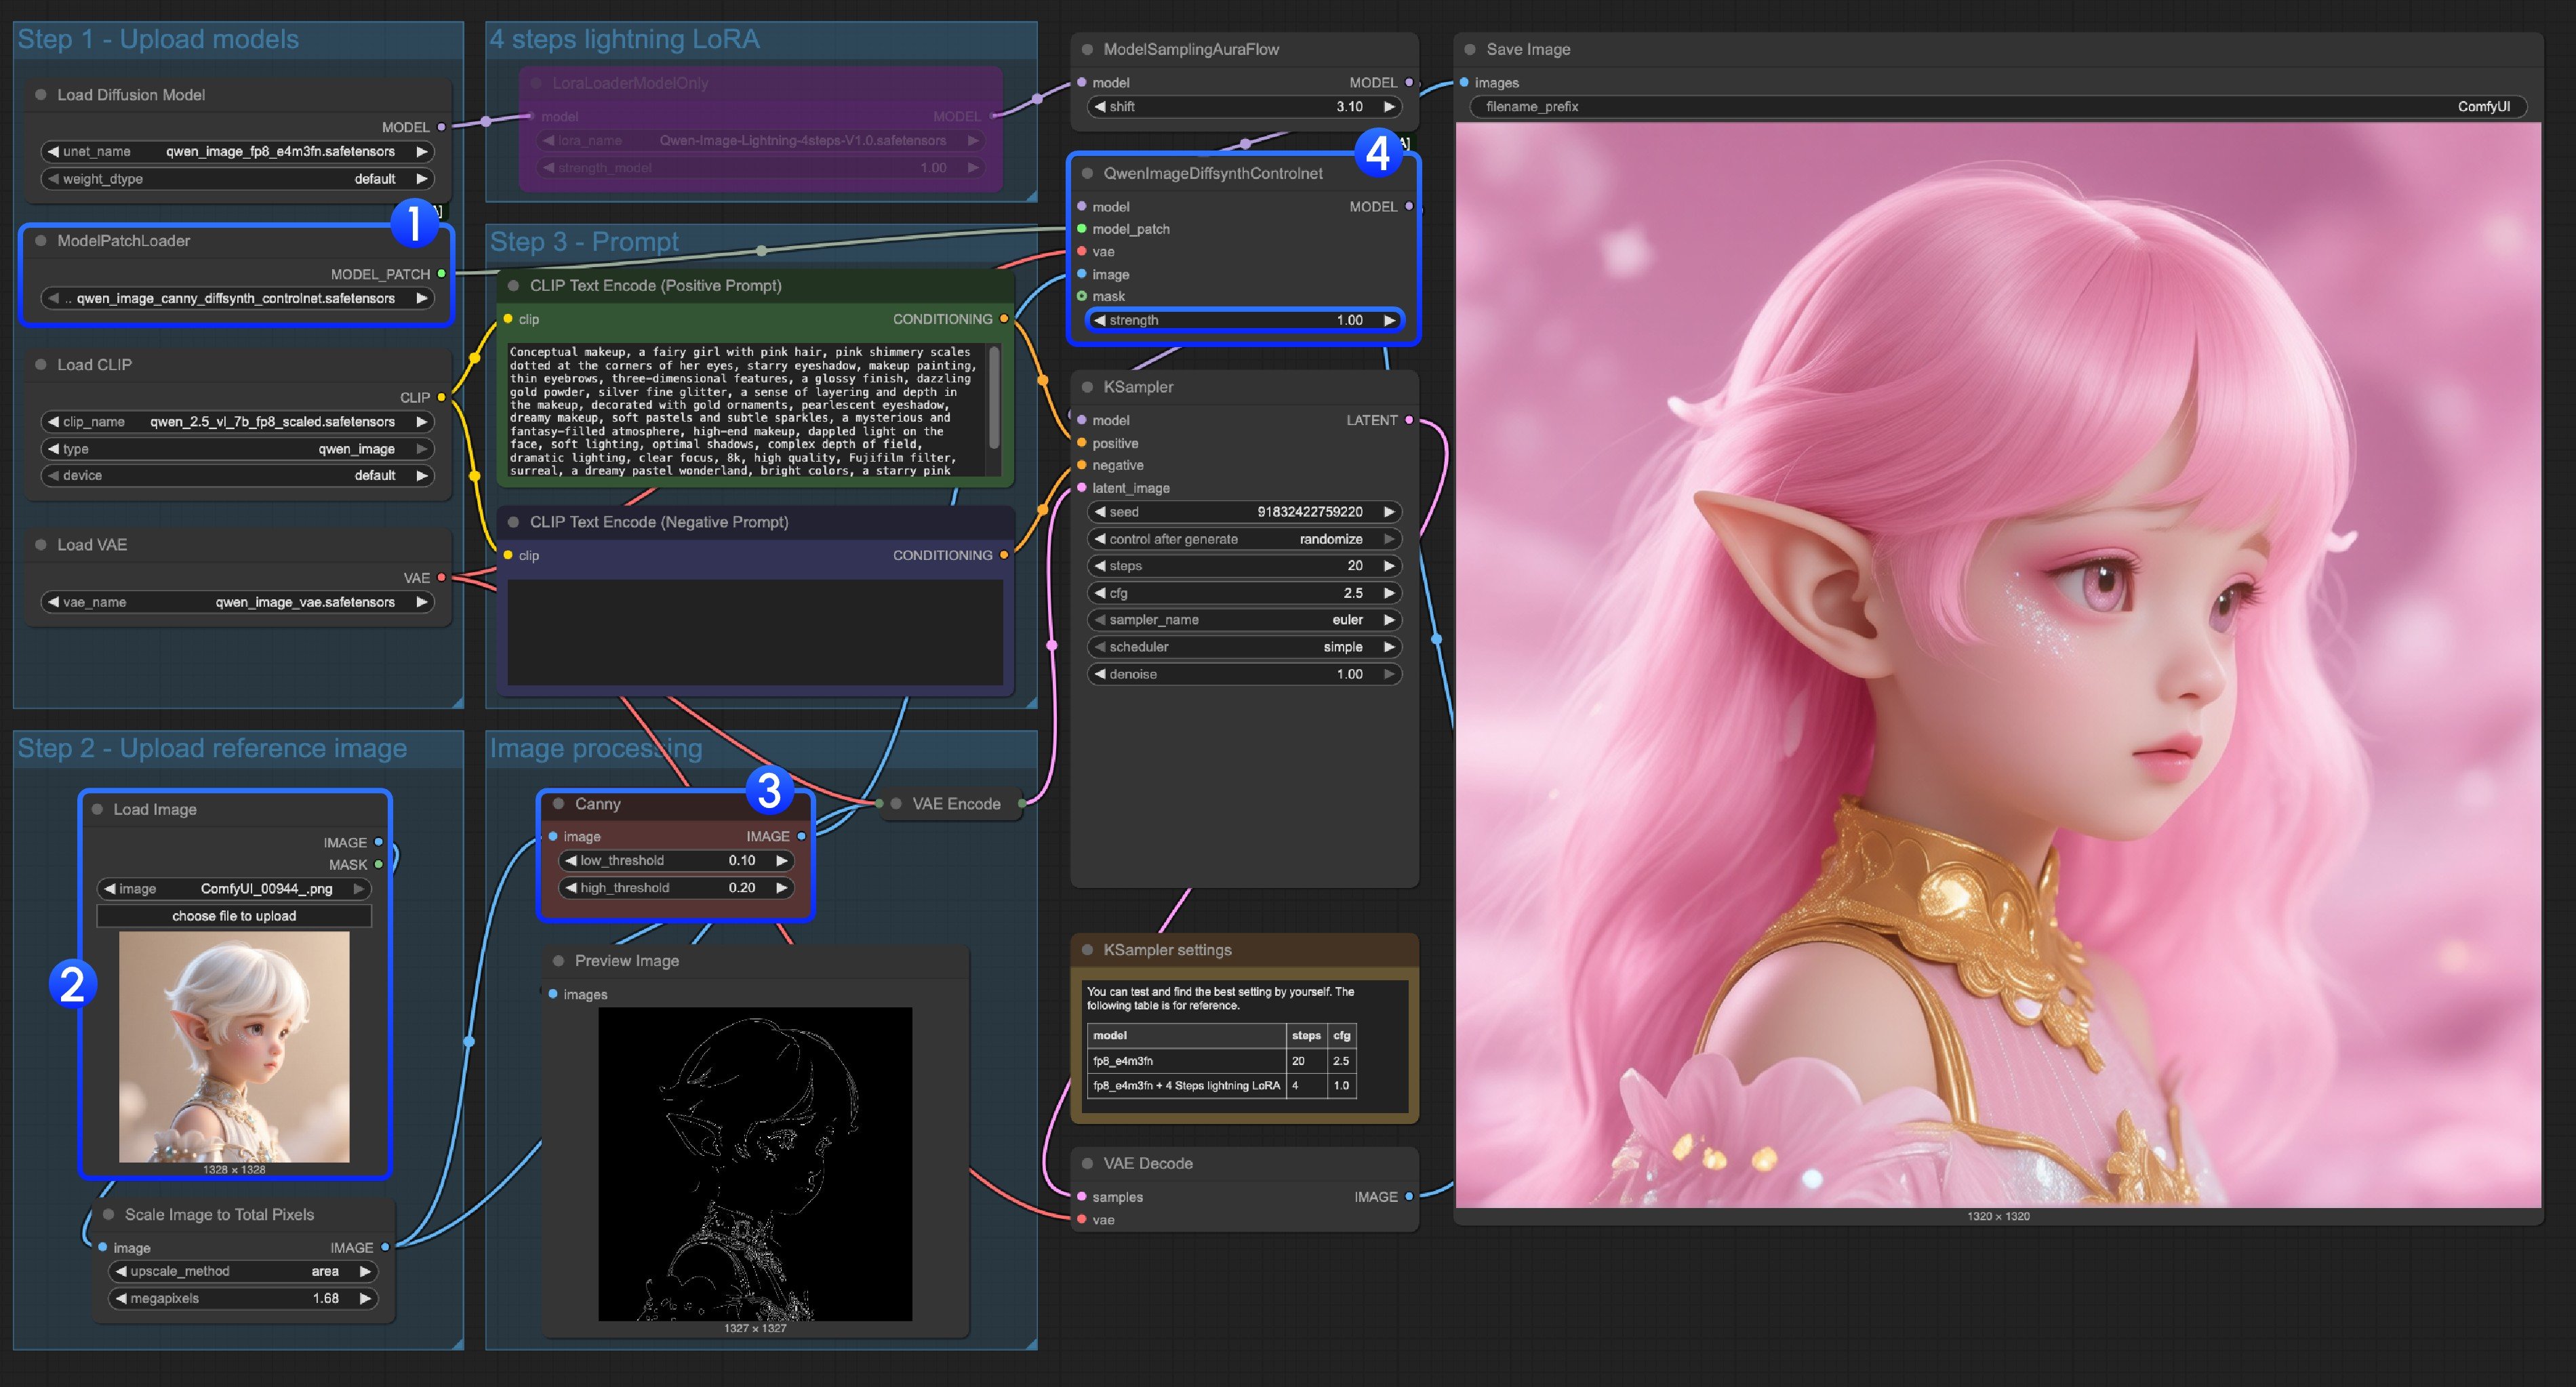
- 确保对应
qwen_image_canny_diffsynth_controlnet.safetensors已被加载 - 上传输入图片,用于后续处理
- Canny 节点是原生的预处理节点,它将按照你设置的参数,将输入图像进行预处理,控制生成
- 如果需要可以修改
QwenImageDiffsynthControlnet节点的strength强度来控制线稿控制的强度 - 点击
Run按钮,或者使用快捷键Ctrl(cmd) + Enter(回车)来运行工作流
对于 qwen_image_depth_diffsynth_controlnet.safetensors 使用,需要将图像预处理成 depth 深度图,替换掉
image processing图,对于这部分的使用,请参考本篇文档中 InstantX 的处理方法,其它部分与 Canny 模型的使用类似
Inpaint 模型 ControlNet 使用说明
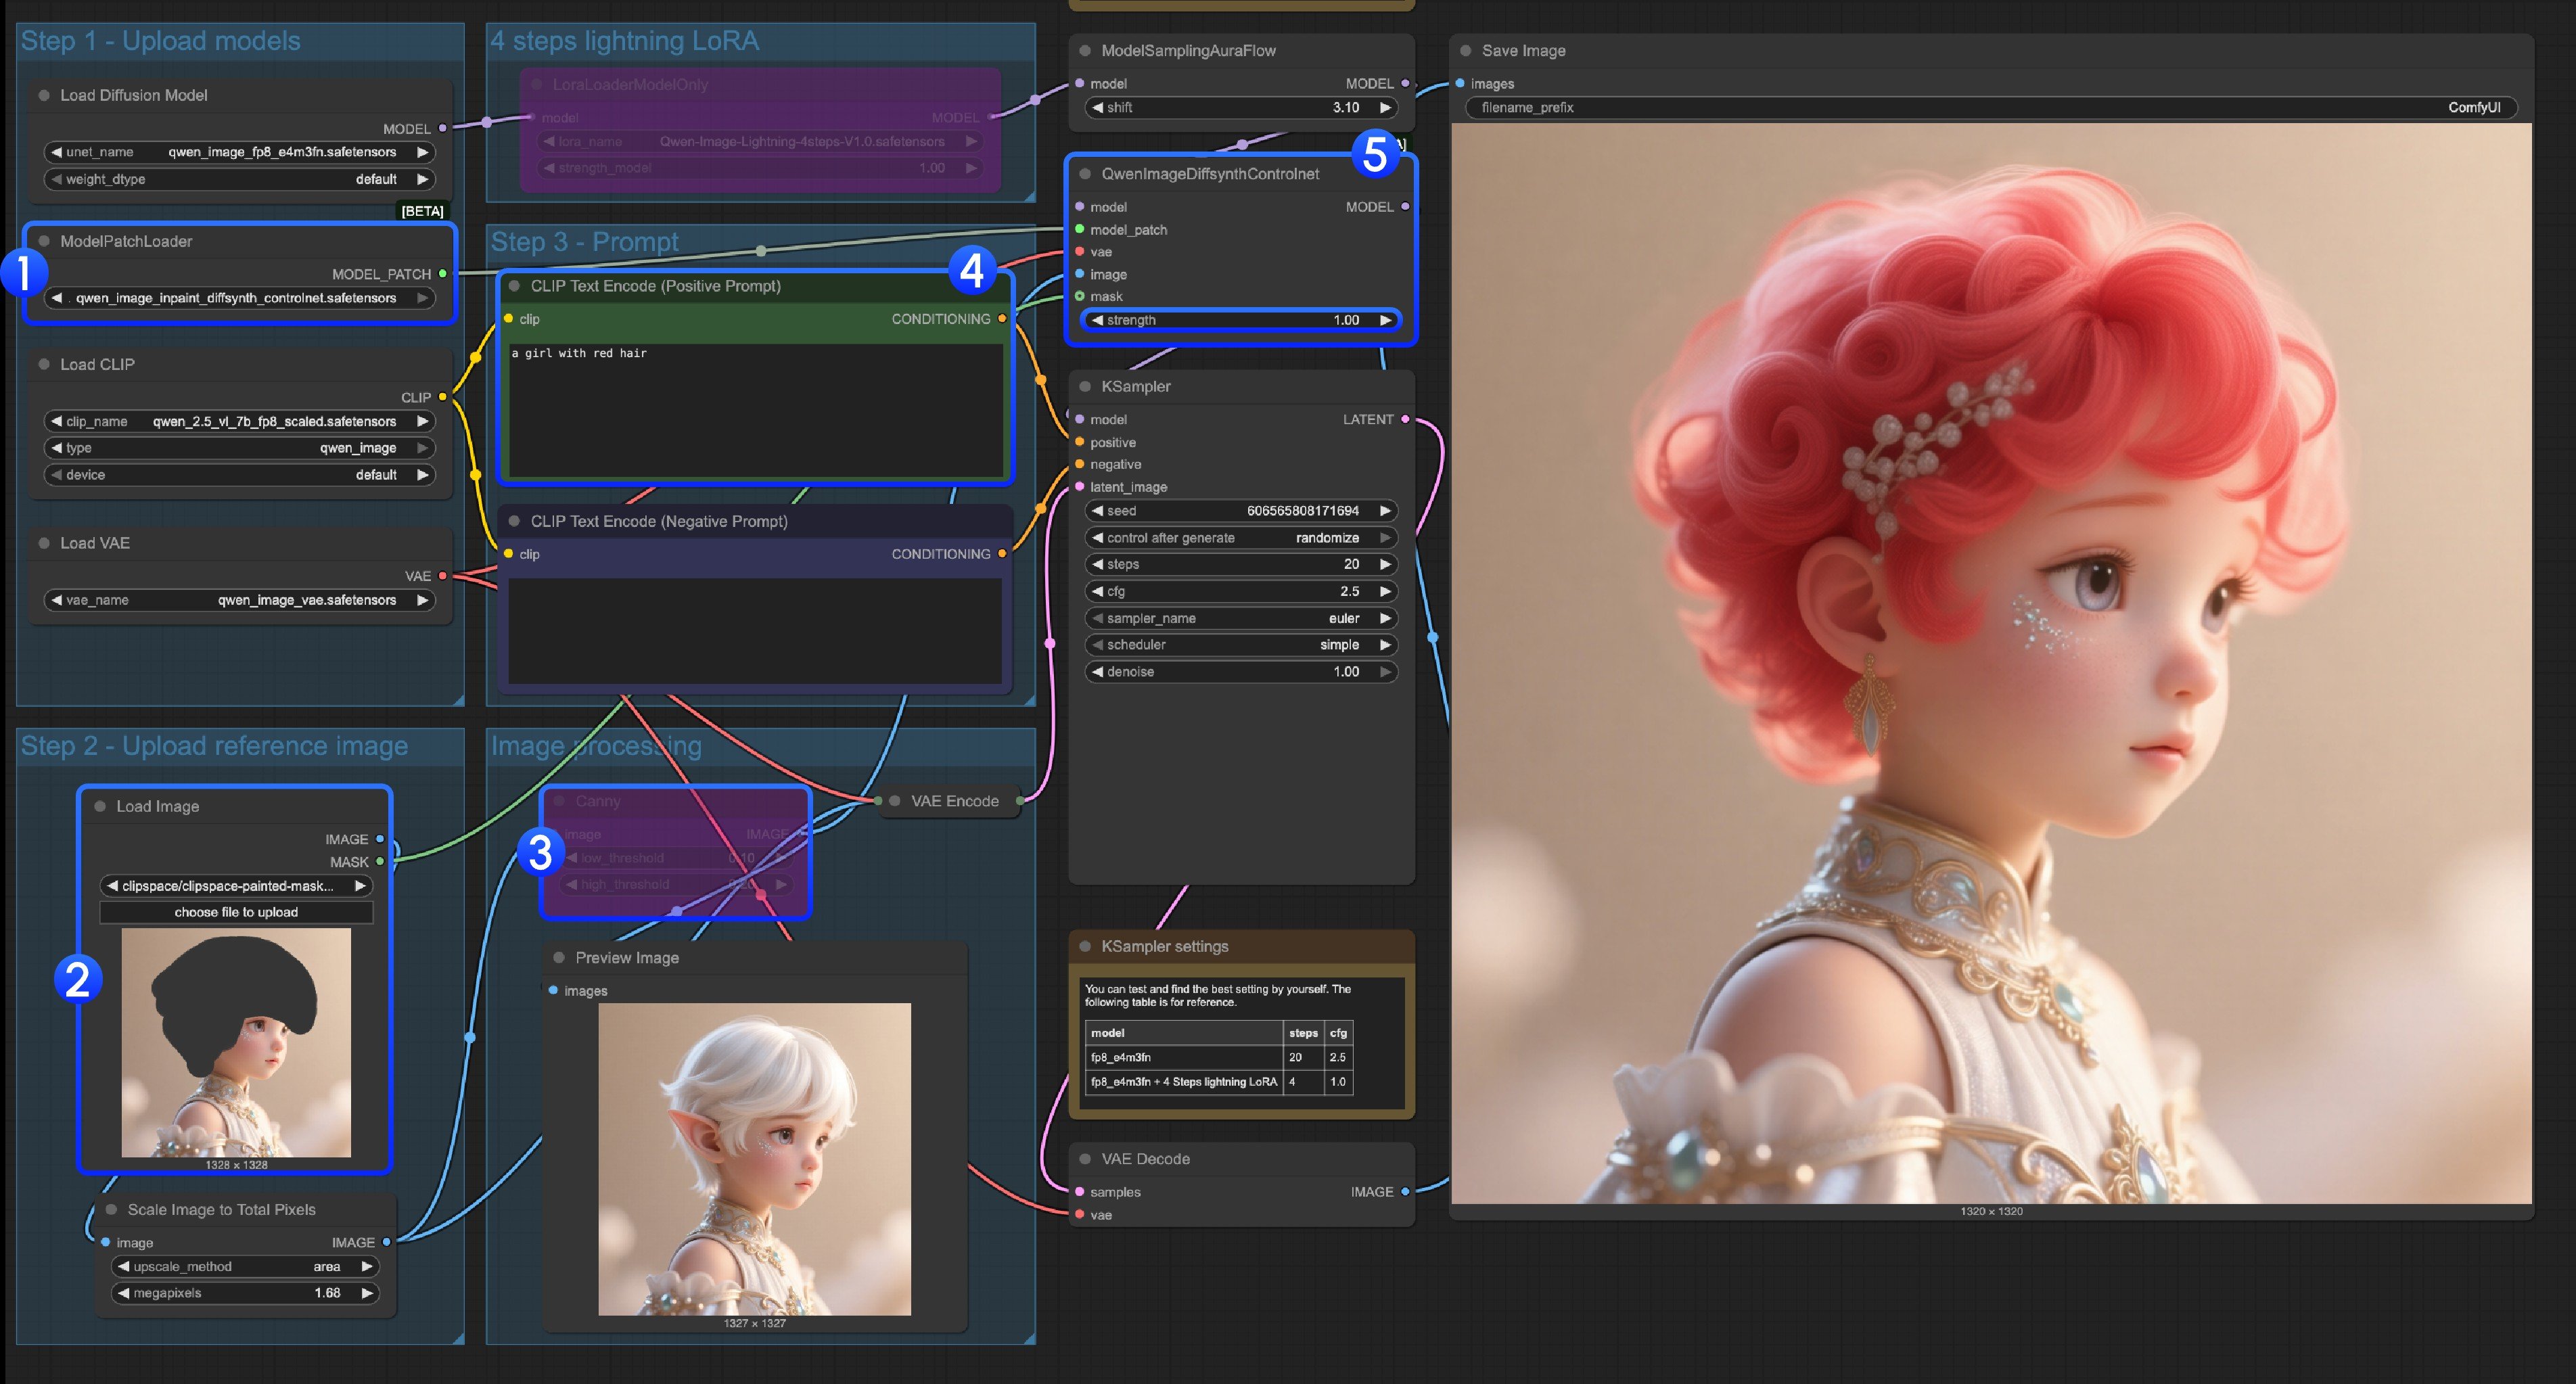
对于 Inpaint 模型,它需要使用 蒙版编辑器,来绘制一个蒙版然后作为输入控制条件
- 确保
ModelPatchLoader加载的是qwen_image_inpaint_diffsynth_controlnet.safetensors模型 - 上传图片,并使用蒙版编辑器 绘制蒙版,你需要将对应
Load Image节点的mask输出连接到QwenImageDiffsynthControlnet的mask输入才能保证对应的蒙版被加载 - 使用
Ctrl-B快捷键,将原本工作流中的 Canny 设置为绕过模式,来使得对应的 Canny 节点处理不生效 - 在
CLIP Text Encoder输入你需要将蒙版部分修改成样式 - 如需要可以修改
QwenImageDiffsynthControlnet节点的strength强度来控制对应的控制强度 - 点击
Run按钮,或者使用快捷键Ctrl(cmd) + Enter(回车)来运行工作流
Qwen Image Union ControlNet LoRA 工作流
Qwen-Image Union Control
使用 Qwen-Image 的统一 ControlNet LoRA 生成具有精确结构控制的图像。支持多种控制类型,包括 canny、depth、线稿、softedge、法线和 openpose。
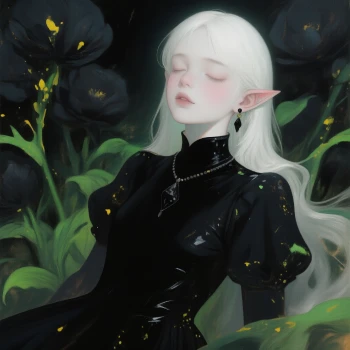
输入材料
将此文件上传到对应的 LoadImage 节点:
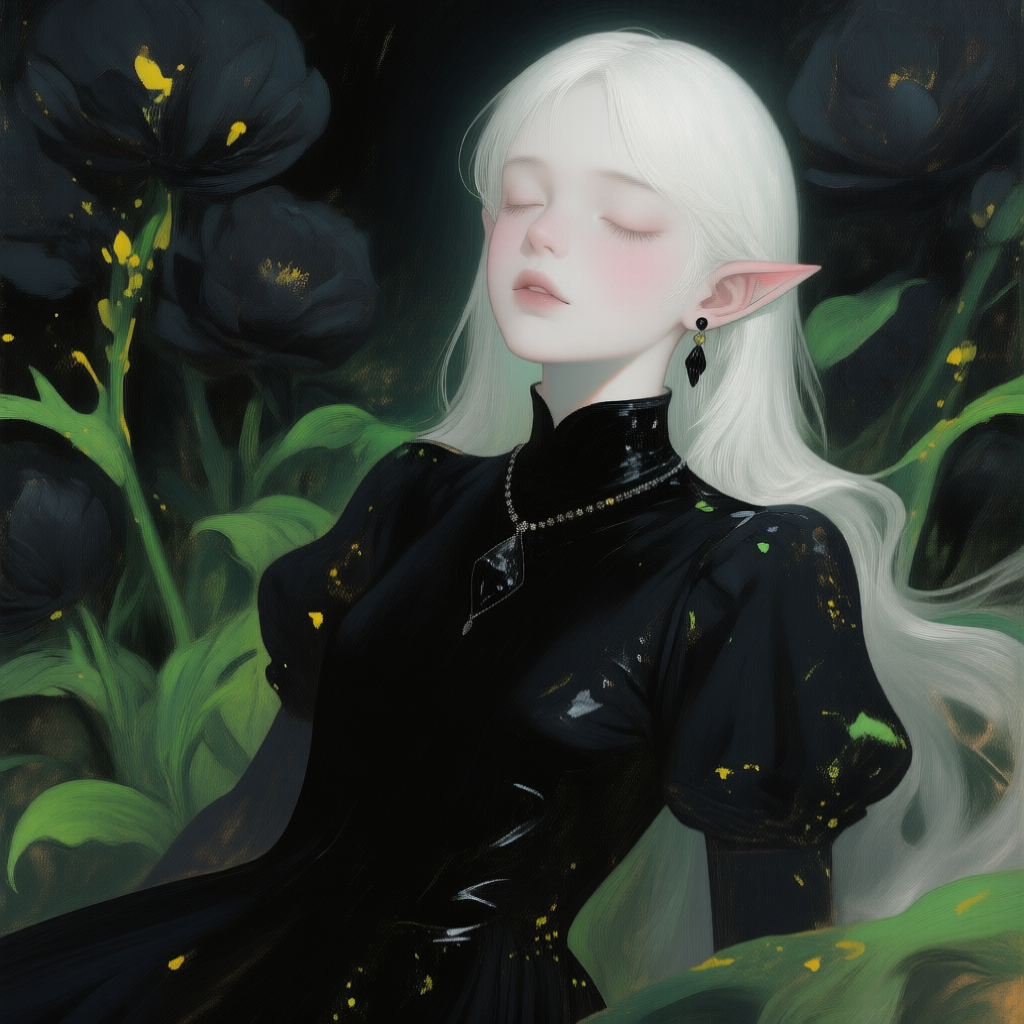
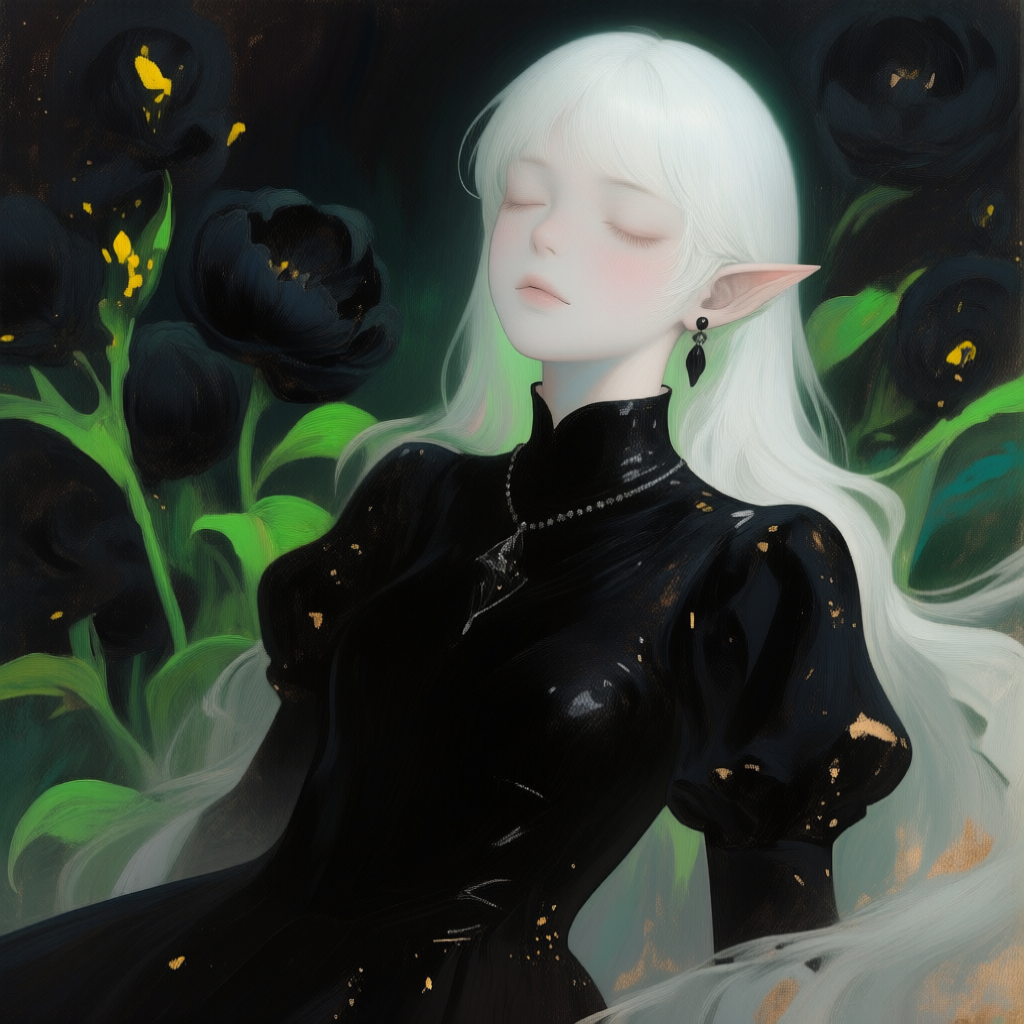
示例输出
原始模型地址:DiffSynth-Studio/Qwen-Image-In-Context-Control-Union Comfy Org 重新托管地址:qwen_image_union_diffsynth_lora.safetensors:支持 canny、depth、pose、线稿、softedge、法线、openpose 的图像结构控制 LoRA
1. 工作流及输入图像
更新 ComfyUI 之后,你可以从模板中找到工作流文件,或者将上方的工作流预览拖入 ComfyUI 中进行加载。
2. 模型链接
下载下面的模型。由于这是一个 LoRA 模型,需要保存到 ComfyUI/models/loras/ 文件夹下
- qwen_image_union_diffsynth_lora.safetensors:支持 canny、depth、pose、线稿、softedge、法线、openpose 的图像结构控制 LoRA
3. 工作流说明
这个模型是一个统一控制 LoRA,支持 canny、depth、pose、线稿、softedge、法线、openpose 控制。由于许多图像预处理原生节点并未完全支持,你应该使用类似 comfyui_controlnet_aux 的工具来完成其他图像预处理。
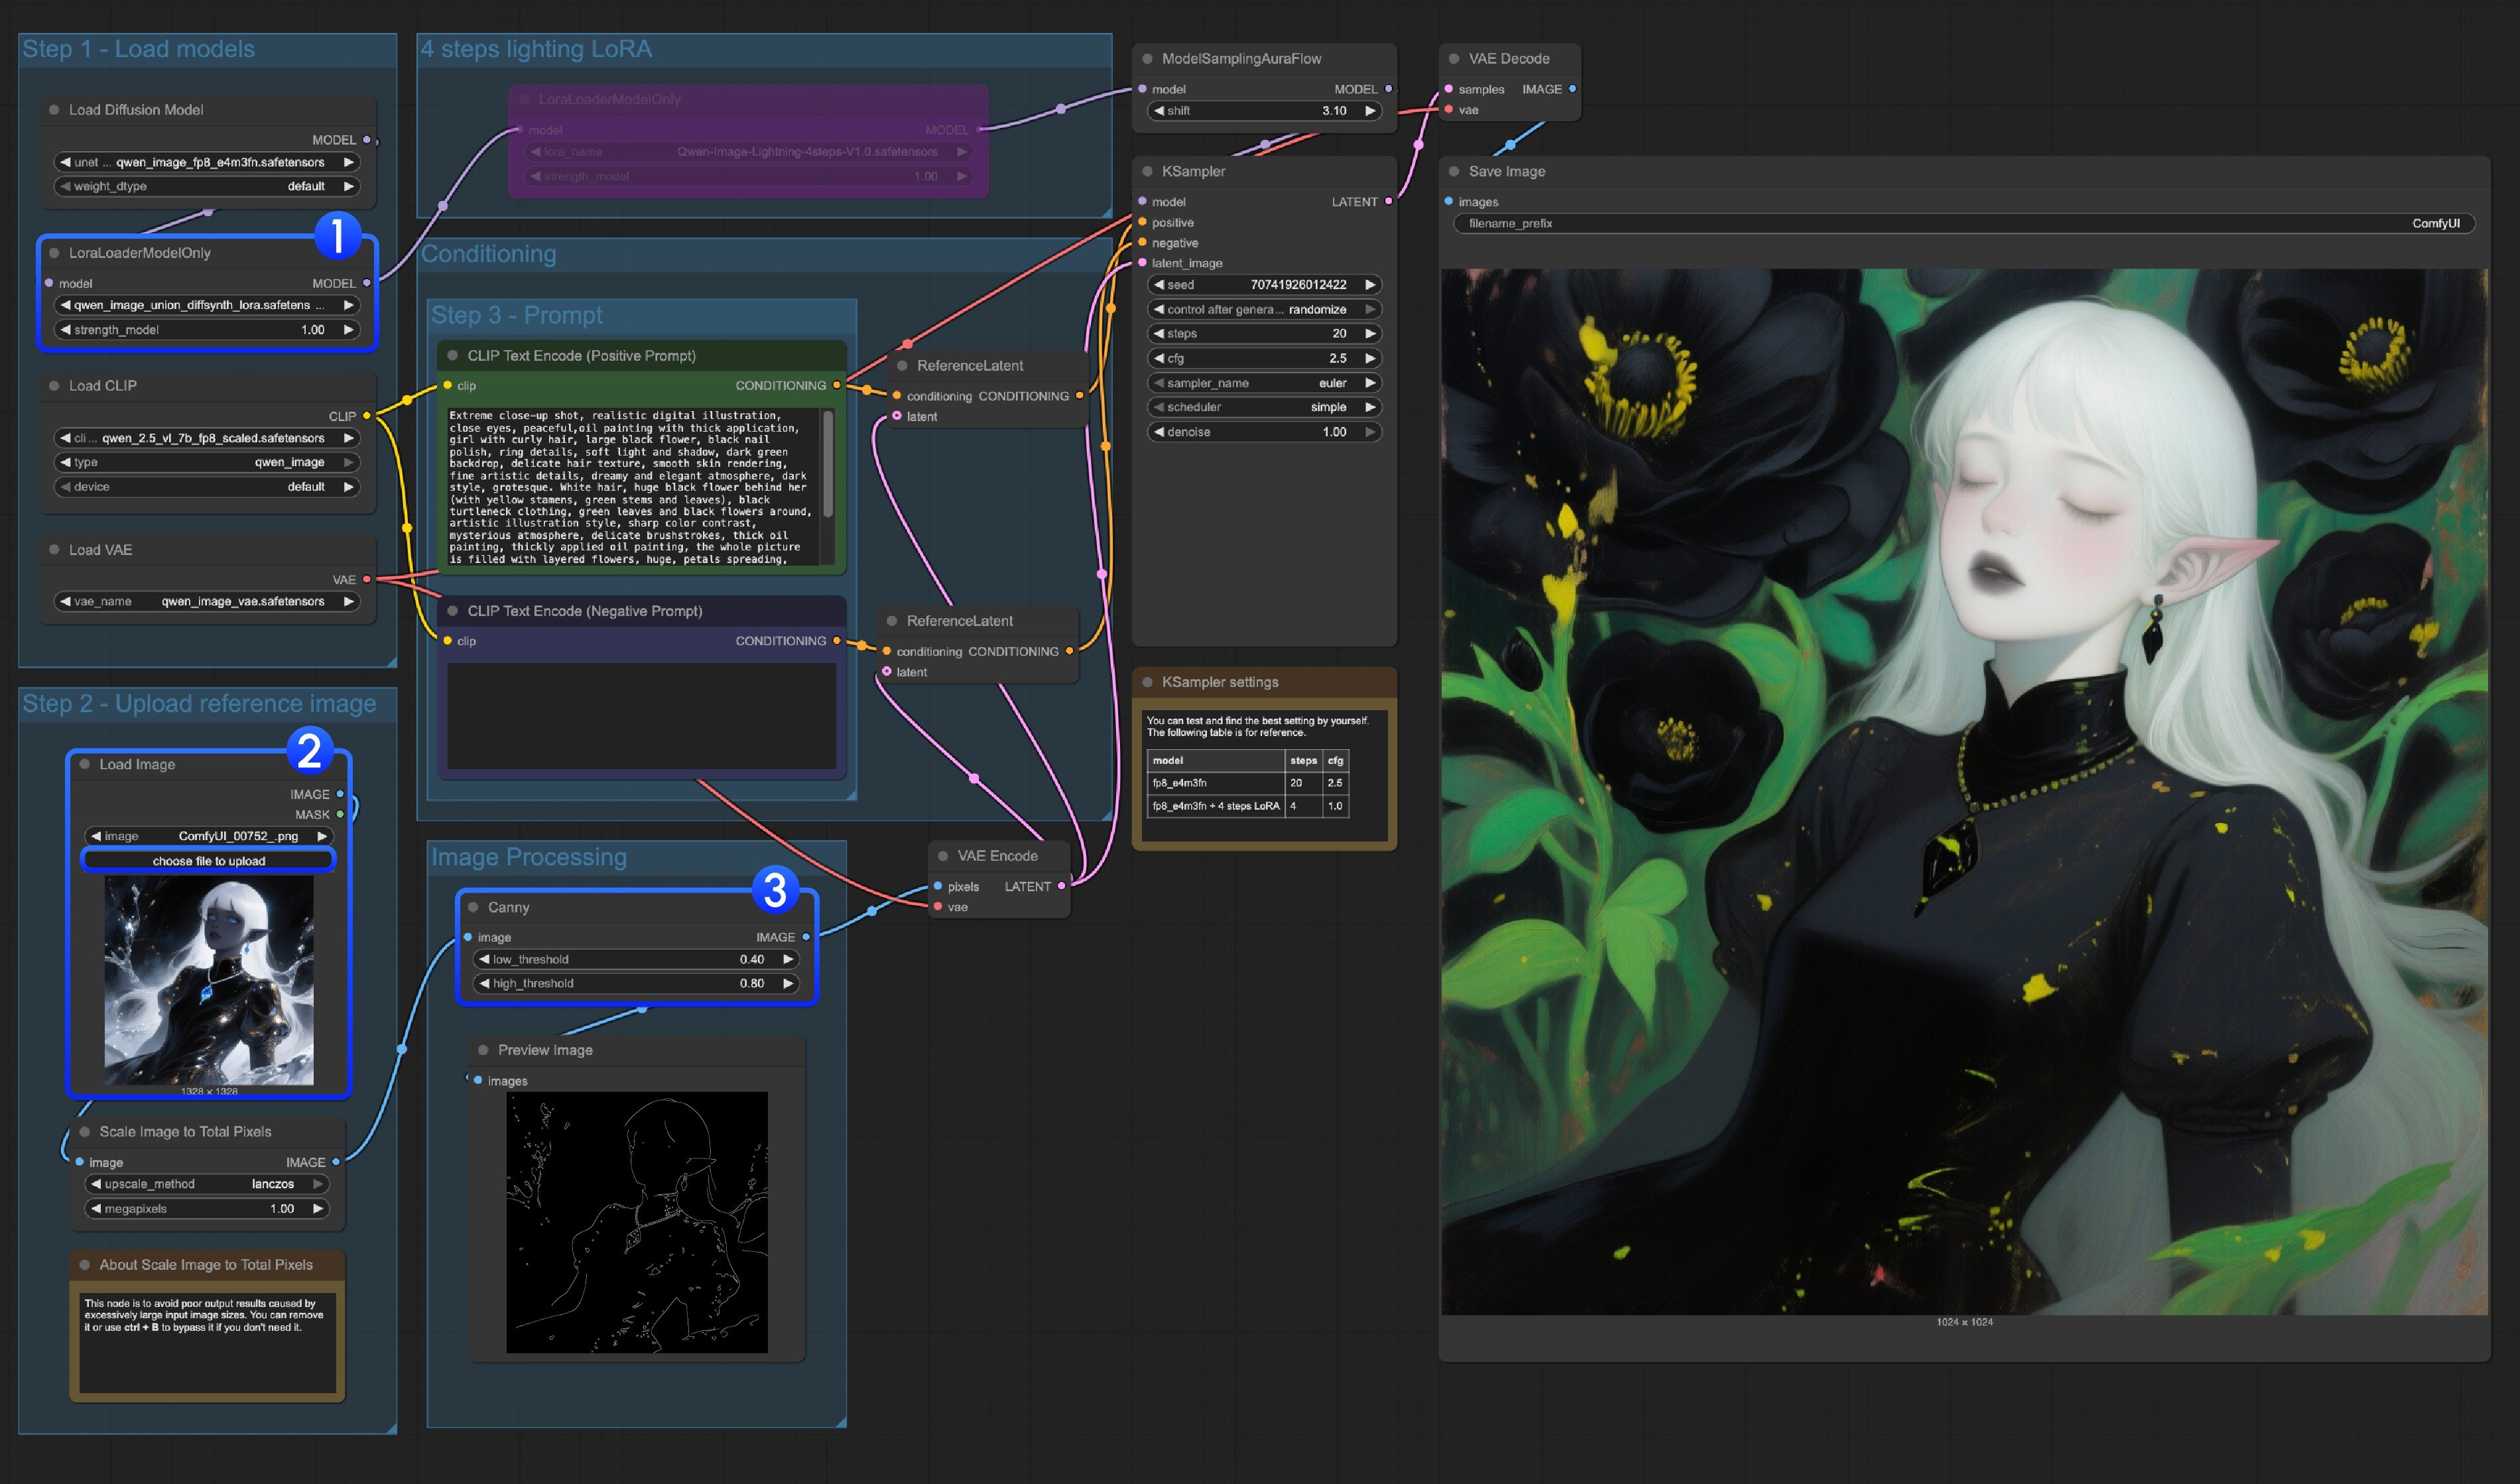
- 确保
LoraLoaderModelOnly正确加载qwen_image_union_diffsynth_lora.safetensors模型 - 上传输入图像
- 如有需要,你可以调整
Canny节点的参数。由于不同的输入图像需要不同的参数设置才能获得更好的图像预处理结果,你可以尝试调整相应的参数值,以获得更多/更少的细节 - 点击
Run按钮,或使用快捷键Ctrl(cmd) + Enter运行工作流
对于其他类型的控制,你还需要替换图像处理部分。