ComfyUI Pose ControlNet 使用示例
在 ComfyUI 中学习 Pose ControlNet。使用 OpenPose 骨骼图控制角色姿态,并通过两次生成的工作流创建大尺寸图像。
OpenPose 简介
OpenPose 是由卡耐基梅隆大学(CMU)开发的开源实时多人姿态估计系统,是计算机视觉领域的重要技术突破。该系统能够同时检测图像中多个人的:
- 人体骨架:18个关键点,包括头部、肩膀、手肘、手腕、髋部、膝盖和脚踝等
- 面部表情:70个面部关键点,用于捕捉微表情和面部轮廓
- 手部细节:21个手部关键点,精确表达手指姿势和手势
- 脚部姿态:6个脚部关键点,记录站立姿势和动作细节
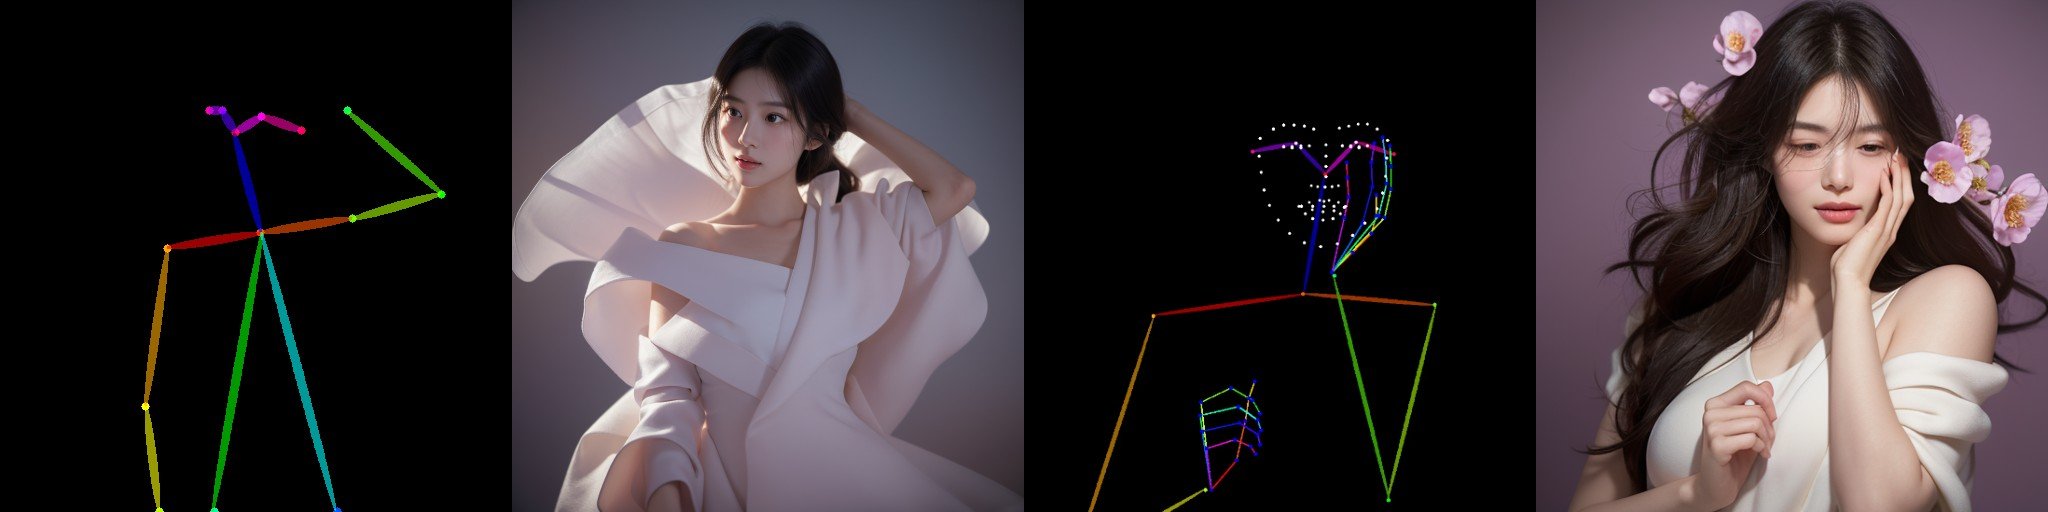
在 AI 图像生成领域,OpenPose 生成的骨骼结构图作为 ControlNet 的条件输入,能够精确控制生成人物的姿势、动作和表情,让我们能够按照预期的姿态和动作生成逼真的人物图像,极大提高了 AI 生成内容的可控性和实用价值。 特别针对早期 Stable diffusion 1.5 系列的模型,通过 OpenPose 生成的骨骼图,可以有效避免人物动作、肢体、表情畸变的问题。
ComfyUI 2-Pass Pose ControlNet 使用示例
1. Pose ControlNet 工作流素材
请下载下面的工作流图片,并拖入 ComfyUI 以加载工作流:
元数据中包含工作流 JSON 的图片可直接拖入 ComfyUI,或使用菜单 Workflows -> Open (ctrl+o) 来加载工作流。
该图片已包含对应模型的下载链接,直接拖入 ComfyUI 将会自动提示下载。
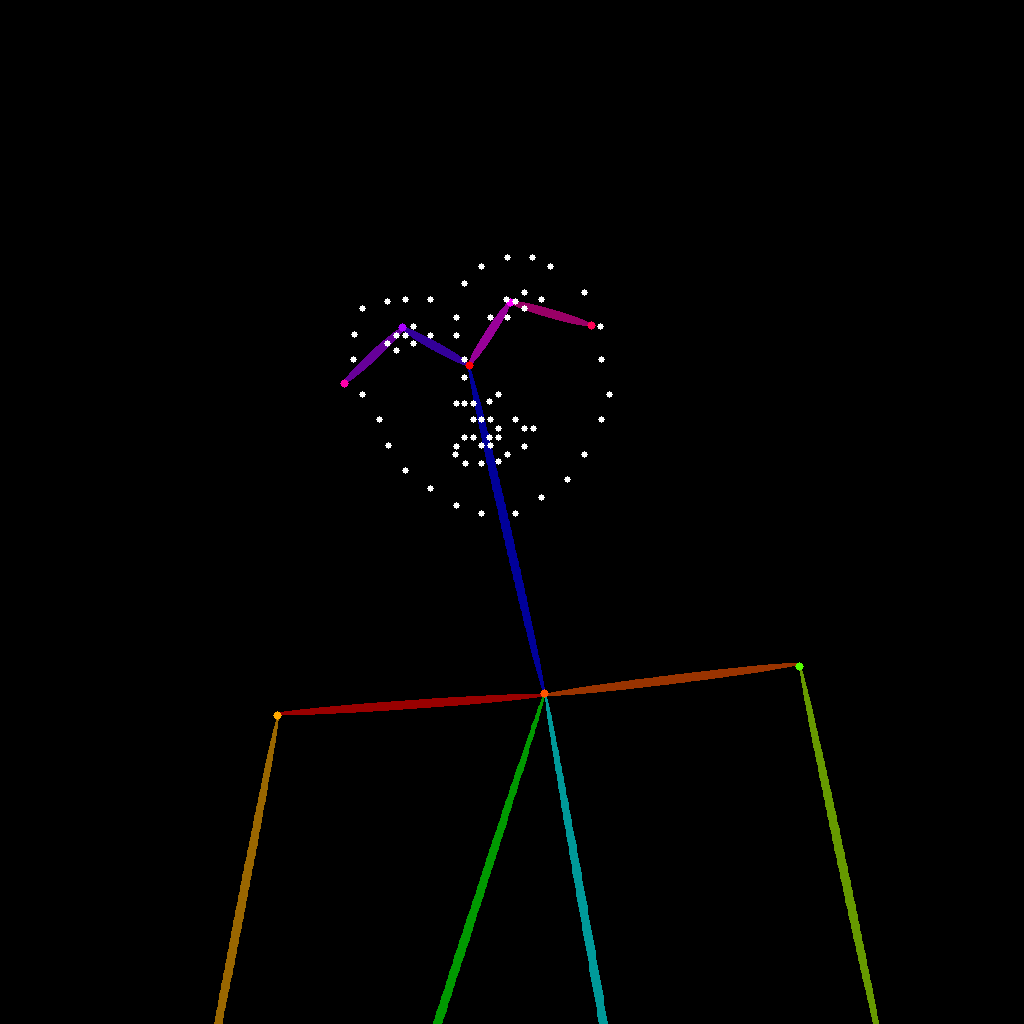
请下载下面的图片,我们将把它作为输入:
2. 手动安装模型
如果你的网络无法顺利完成对应模型的自动下载,请尝试手动下载下面的模型,并放置到指定目录:
- control_v11p_sd15_openpose_fp16.safetensors
- majicmixRealistic_v7.safetensors
- japaneseStyleRealistic_v20.safetensors
- vae-ft-mse-840000-ema-pruned.safetensors
ComfyUI/
├── models/
│   ├── checkpoints/
│   │   └── majicmixRealistic_v7.safetensors
│   │   └── japaneseStyleRealistic_v20.safetensors
│   ├── vae/
│   │   └── vae-ft-mse-840000-ema-pruned.safetensors
│   └── controlnet/
│       └── control_v11p_sd15_openpose_fp16.safetensors
3. 分步执行工作流
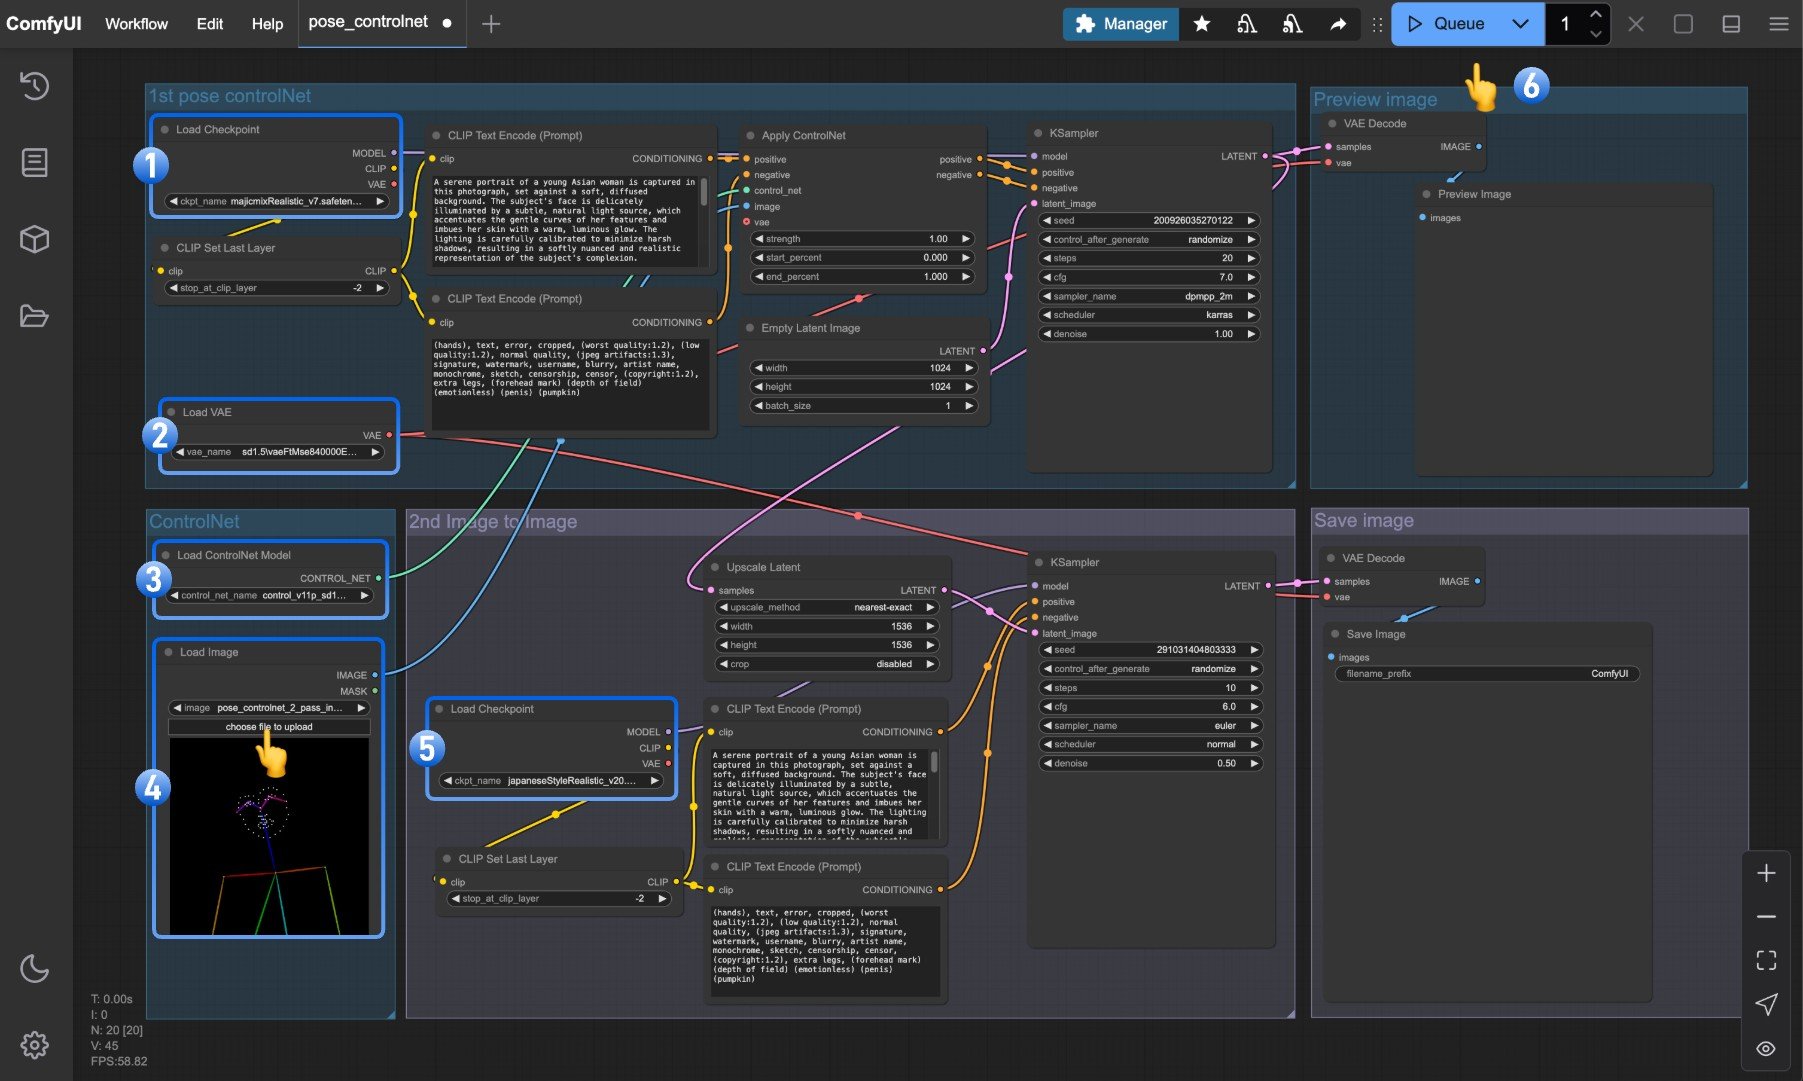
按照图片中的数字标记,执行以下步骤:
- 确保
Load Checkpoint可以加载 majicmixRealistic_v7.safetensors。 - 确保
Load VAE可以加载 vae-ft-mse-840000-ema-pruned.safetensors。 - 确保
Load ControlNet Model可以加载 control_v11p_sd15_openpose_fp16.safetensors。 - 点击
Load Image节点中的选择按钮,上传之前提供的姿态输入图片,或使用你自己的 OpenPose 骨骼图。 - 确保
Load Checkpoint可以加载 japaneseStyleRealistic_v20.safetensors。 - 点击
Queue按钮,或使用快捷键Ctrl(cmd) + Enter来执行图像生成。
Pose ControlNet 二次图生图工作流讲解
本工作流采用二次图生图(2-pass)的方式,将图像生成分为两个阶段:
第一阶段:基础姿态图像生成
在第一阶段,使用majicmixRealistic_v7模型结合Pose ControlNet生成初步的人物姿态图像:
- 首先通过
Load Checkpoint加载majicmixRealistic_v7模型 - 通过
Load ControlNet Model加载姿态控制模型 - 输入的姿态图被送入
Apply ControlNet节点与正向和负向提示词条件结合 - 第一个
KSampler节点(通常使用20-30步)生成基础的人物姿态图像 - 通过
VAE Decode解码得到第一阶段的像素空间图像
这个阶段主要关注正确的人物姿态、姿势和基本结构,确保生成的人物符合输入的骨骼姿态。
第二阶段:风格优化与细节增强
在第二阶段,将第一阶段的输出图像作为参考,使用japaneseStyleRealistic_v20模型进行风格化和细节增强:
- 第一阶段生成的图像通过
Upscale latent节点创建的更大分辨率的潜在空间 - 第二个
Load Checkpoint加载japaneseStyleRealistic_v20模型,这个模型专注于细节和风格 - 第二个
KSampler节点使用较低的denoise强度(通常0.4-0.6)进行细化,保留第一阶段的基础结构 - 最终通过第二个
VAE Decode和Save Image节点输出更高质量、更大分辨率的图像
这个阶段主要关注风格统一性、细节丰富度和提升整体画面质量。
二次图生图的优势
与单次生成相比,二次图生图方法具有以下优势:
- 更高分辨率:通过二次处理可以生成超出单次生成能力的高分辨率图像
- 风格混合:可以结合不同模型的优势,如第一阶段使用写实模型,第二阶段使用风格化模型
- 更好的细节:第二阶段可以专注于优化细节,而不必担心整体结构
- 精确控制:姿态控制在第一阶段完成后,第二阶段可以专注于风格和细节的完善
- 降低GPU负担:分两次生成可以在有限的GPU资源下生成高质量大图
如需了解更多关于混合多个ControlNet的技巧,请参考混合ControlNet模型教程。